三台 Mac mini,
串成一顆 1200 億參數的大腦
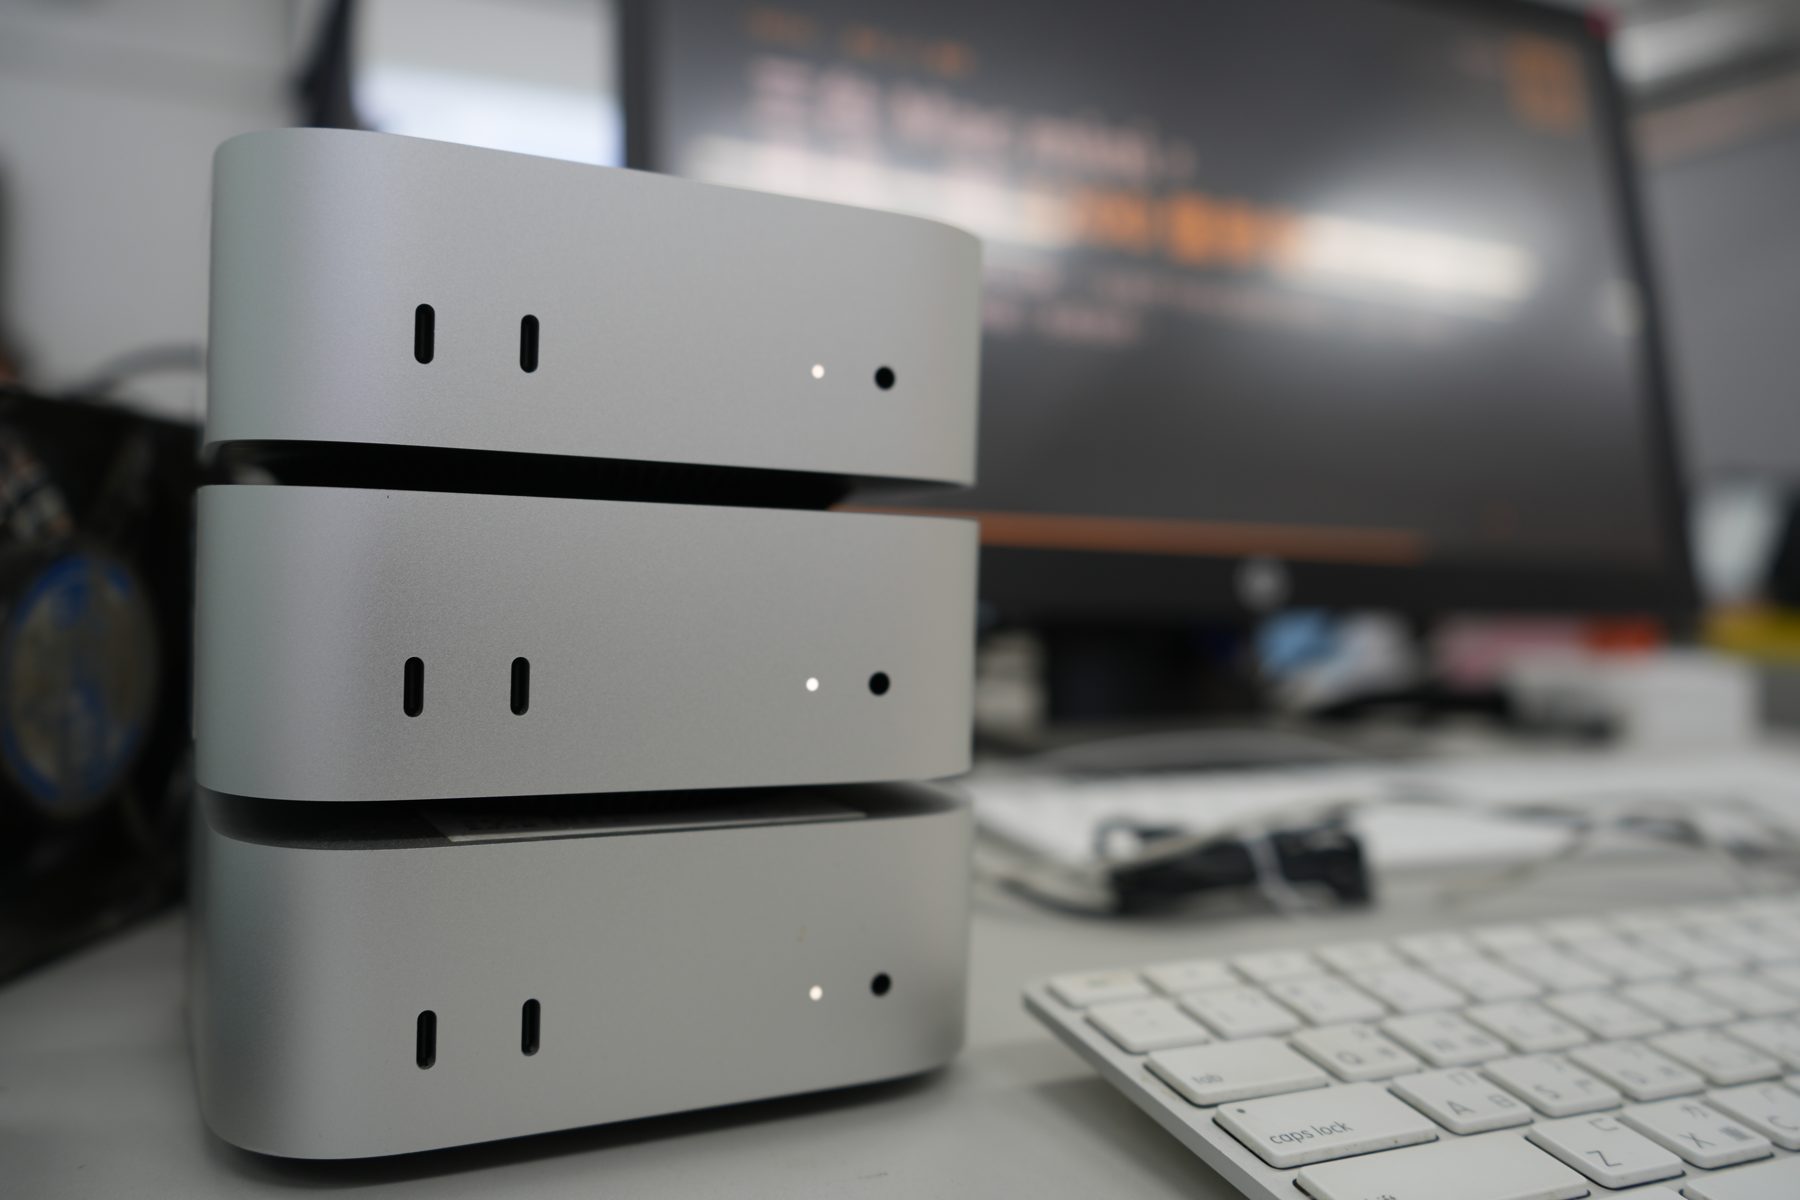
這是資訊科在教室裡架設的校內 AI 叢集。它跑的是 OpenAI 開源的 gpt-oss-120b模型,以三台Mac Mini組成Exo Cluster執行,不過目前只支援文字生成,無法處理圖片或語音。你可以在 Python 程式裡呼叫它,也可以用它做 AI 專題。
什麼是 EXO?
EXO 是一套開源的「分散式推論」軟體:它把一個大型語言模型(LLM)切成好幾段,分給好幾台電腦一起算。就像一本太厚、一個人搬不動的書,拆成三冊由三個人一起搬。
大型語言模型的參數必須全部放進記憶體才能運作。gpt-oss-120b 有 1200 億個參數,壓縮後約 63 GB;我們每台 Mac mini 只有 48~64 GB 記憶體,單台放不下。EXO 把模型的 36 層切成三段,每台負責一段,再用 Thunderbolt 線把運算結果接力傳下去。
為什麼要在校內架 LLM?
不用付 API 費用
雲端 AI 依用量計費,程式寫錯跑成迴圈,一晚就可能燒掉幾千元。在這裡練習,一毛都不用花。
資料不離開學校
你送出的問題、上傳的資料只在校內三台電腦間處理,不會傳到任何雲端公司。
OpenAI 相容 API
用的是和 ChatGPT API 一模一樣的寫法。在這裡學會,將來換成任何雲端服務都只要改一行網址。
1200 億參數
gpt-oss-120b 會「先思考再回答」,寫程式、解數學、做推理都明顯比一般小模型強。
AI 不再是黑盒子
模型就在你眼前的三台機器上跑。分層、記憶體、網路、耗電都能實際觀察,甚至拿來當科展題目。
加一台就更強
再加一台 Mac,叢集就能跑更大的模型。這正是現在 AI 資料中心的運作方式,只是縮小成教室版。
實測數據
2026 年 10 月實測,條件:輸入約 1,200 字元、輸出 256 tokens。
它可以怎麼幫你的專題?
你的程式助教
在 PyCharm 裡直接問它:解釋錯誤訊息、幫你改程式、產生測試資料。
把 AI 放進你的程式
聊天機器人、自動出題、作文回饋、遊戲 NPC……只要幾行 Python。
讓 AI 讀你的資料
把課本、校規、社團資料變成知識庫,做一個「只根據這些資料回答」的問答系統。
研究叢集本身
分散式運算、量化、耗能比較……這台機器本身就是很少見的研究題目。
開始使用
- 向資訊老師領取 API key一人一把。key 就像密碼,不要分享,也不要上傳到 GitHub。
- 連上校內網路叢集只在校內網路開放。Google Colab 在雲端,連不到叢集,原因見 Colab 與 Jupyter。
- 照著「快速開始」寫第一支程式快速開始只要 5 分鐘。用 PyCharm 的同學接著看 PyCharm 設定。