Basic Materials of Python
TNFSH Python教材 / 顏永進
Table of Contents

1. Python 簡介
1.1. Python 是什麼?
Python 是一種高階(high-level)的直譯語言(scripting language,或譯為腳本語言),常用來整合(glue together)大型軟體元件,支援跨平台、多種中介軟體產品,可應用於各種領域。Python 是一種物件導向語言,具備高階資料結構、動態型別與動態繫結的特性。Python 自 1991 年問世以來,一直擁有非常活躍的使用者社群。如需更多資訊,請參閱 Python 官方網站:http://www.python.org。
1.2. Python 的誕生
1.2.1. 一句話講完一個故事
The Martian: 一個男人在火星上種菜的故事
Python: 一個宅男工程師為了打發聖誕假期打造了一種新的程式語言1。
Guido van Rossum
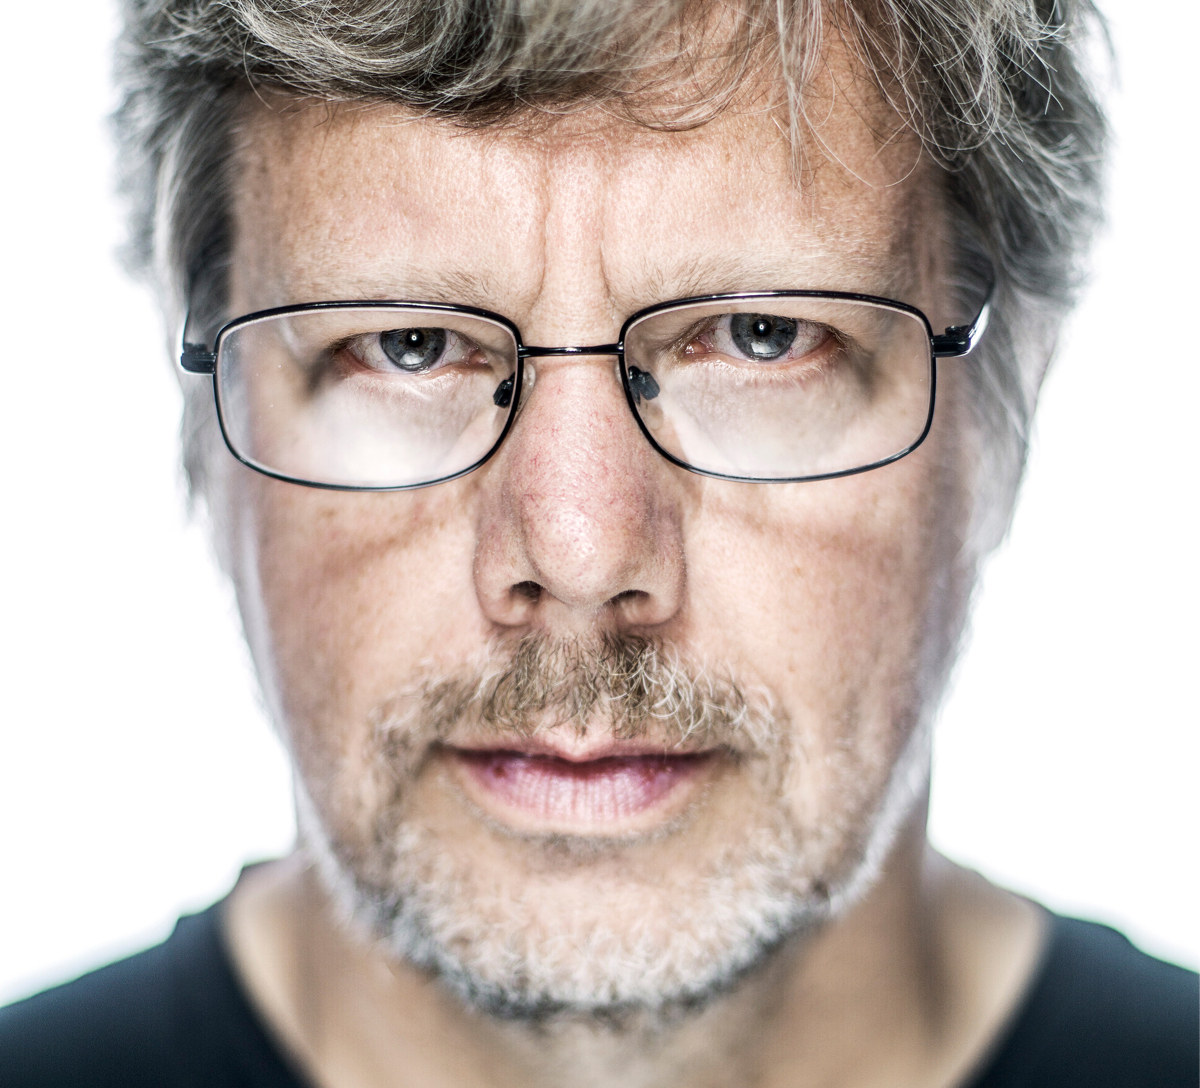
30 年後,每天都有數百萬人使用他創立的這一新語言。
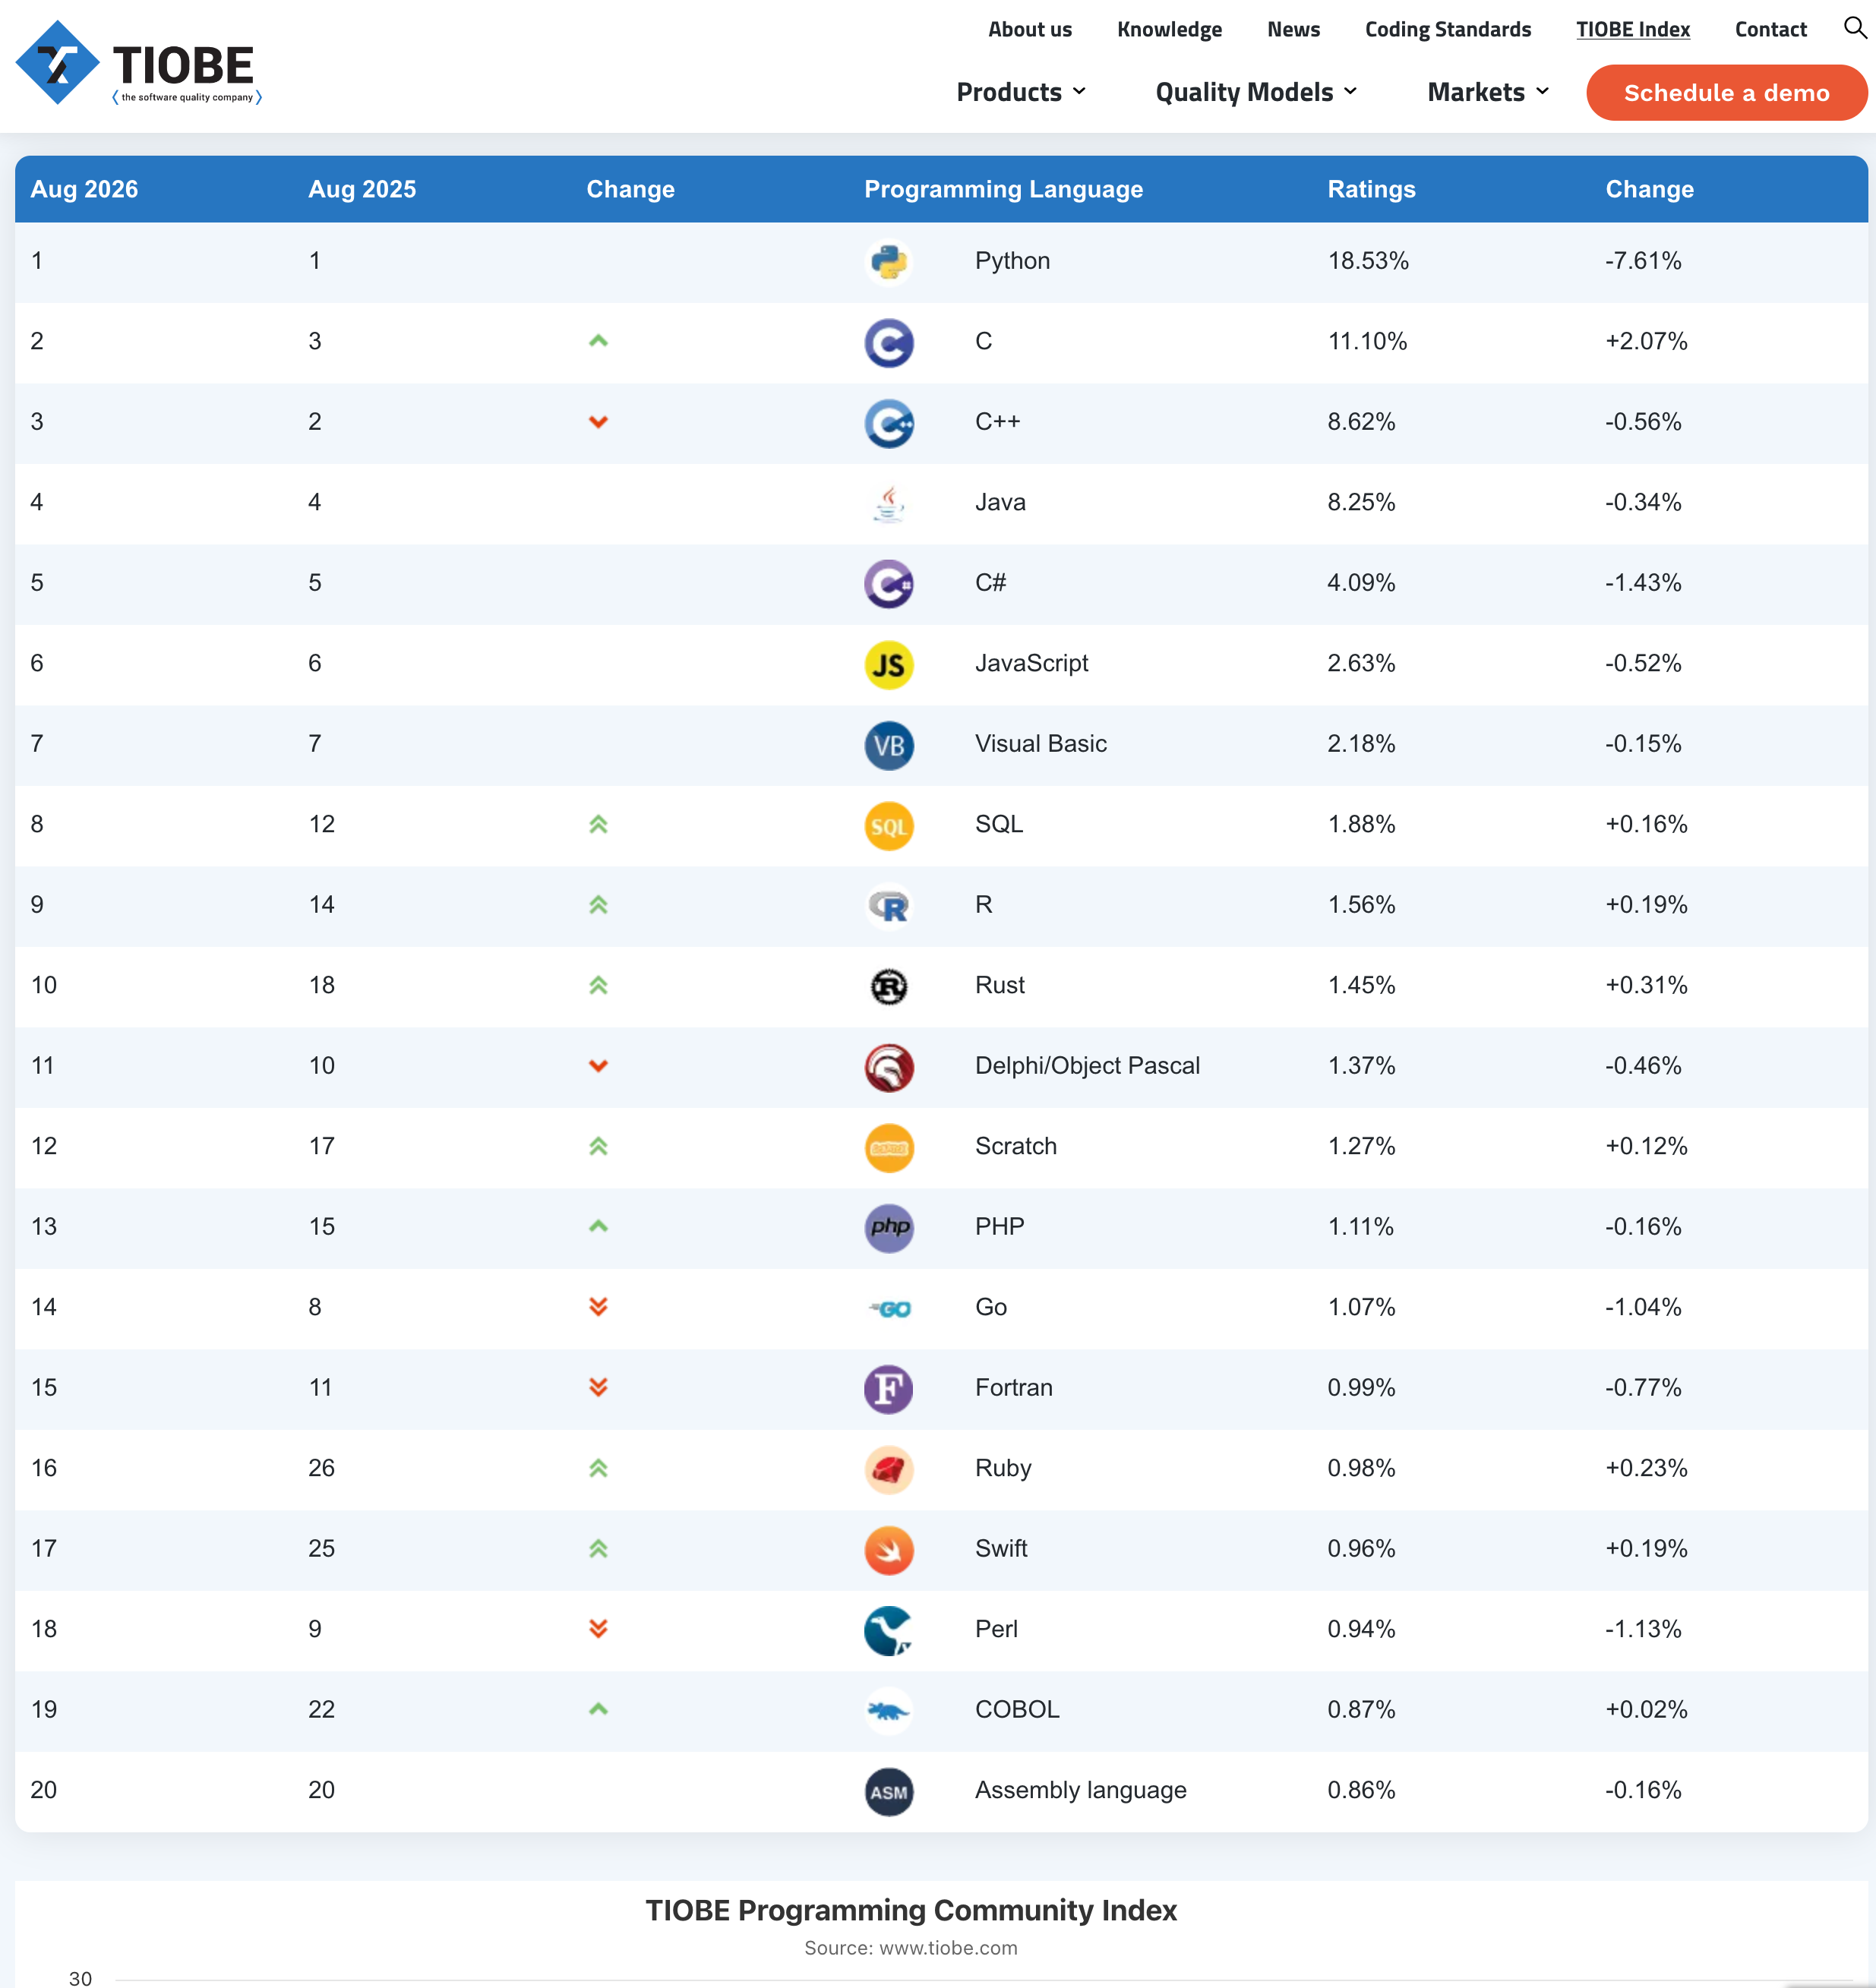
幾種不同語言受歡迎程度的變化:TIOBE 2001-2025
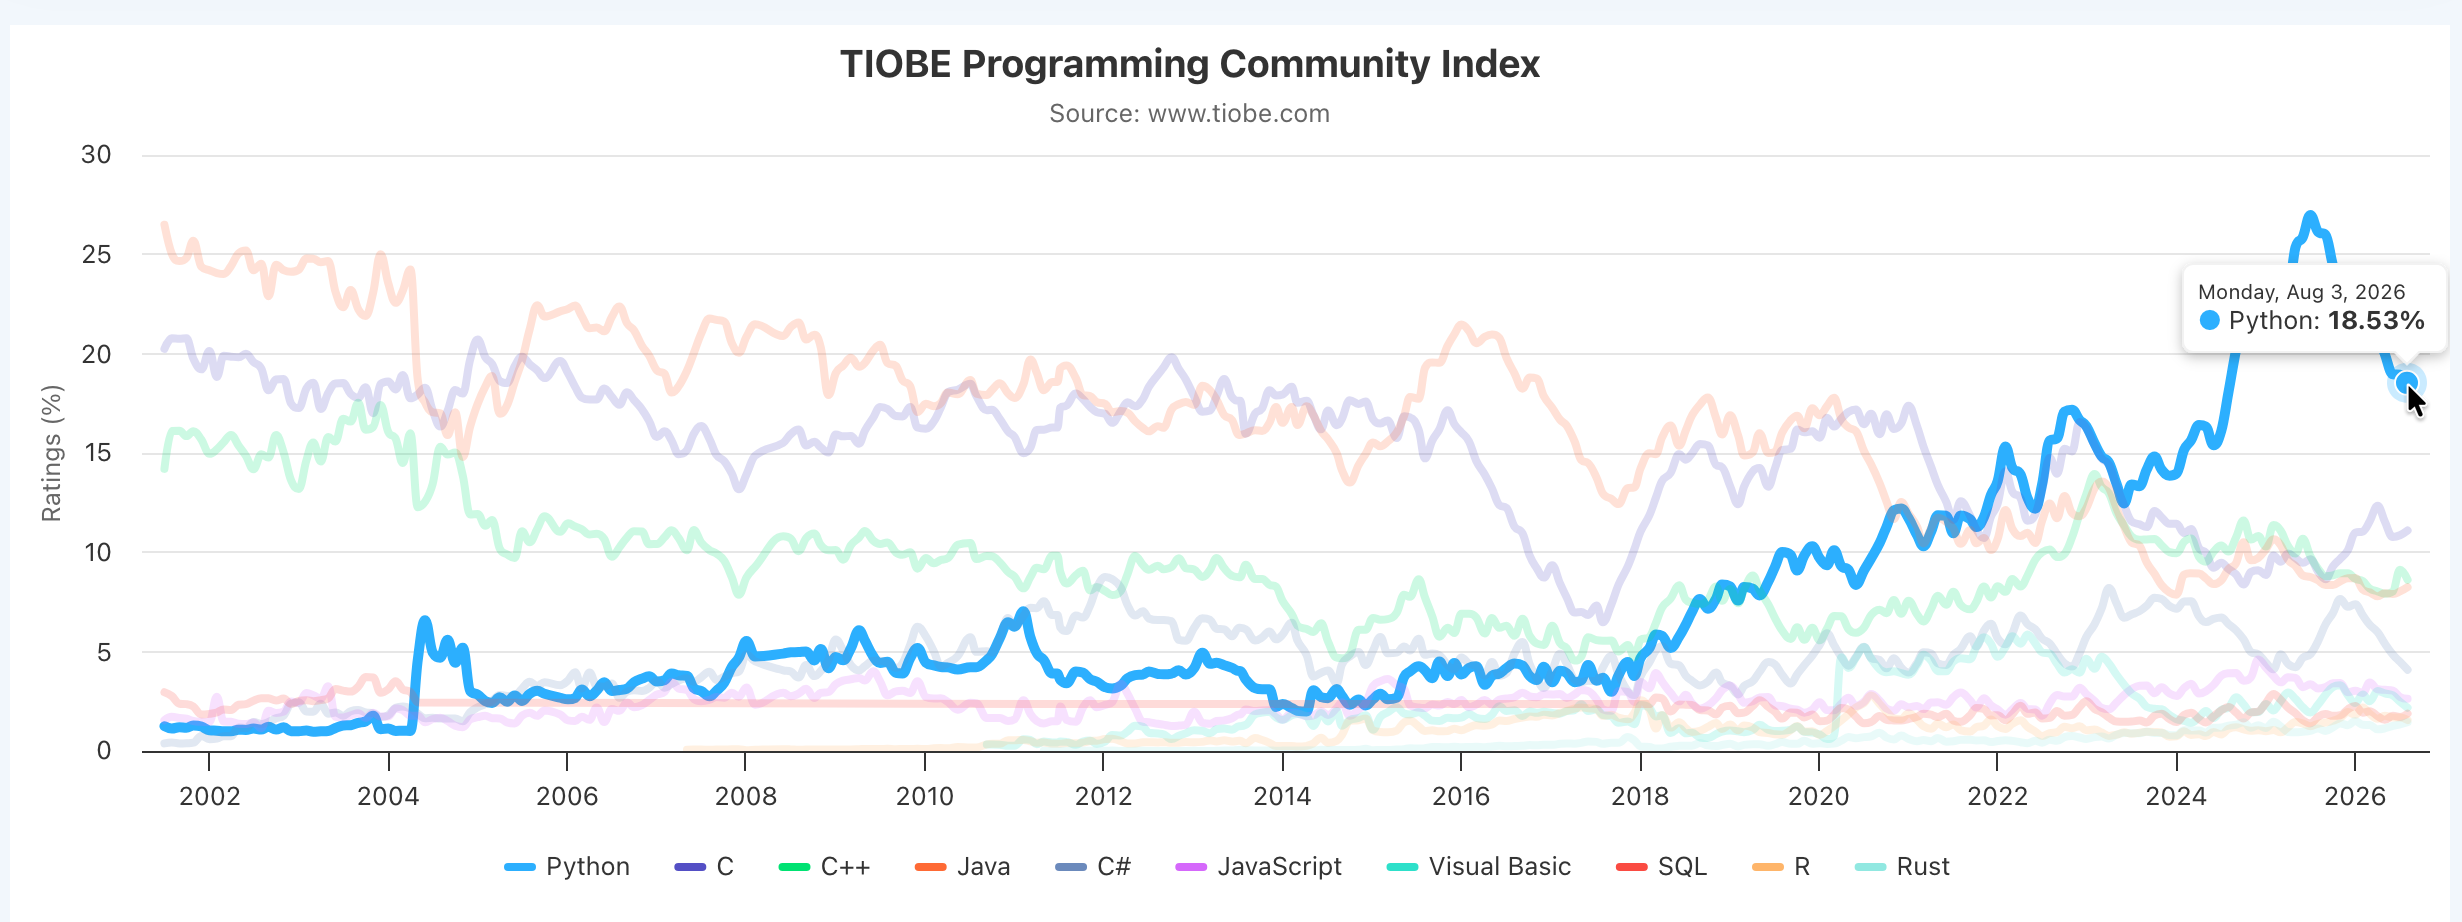
Figure 2: 2002-2026 TIOBE 語言排行變化
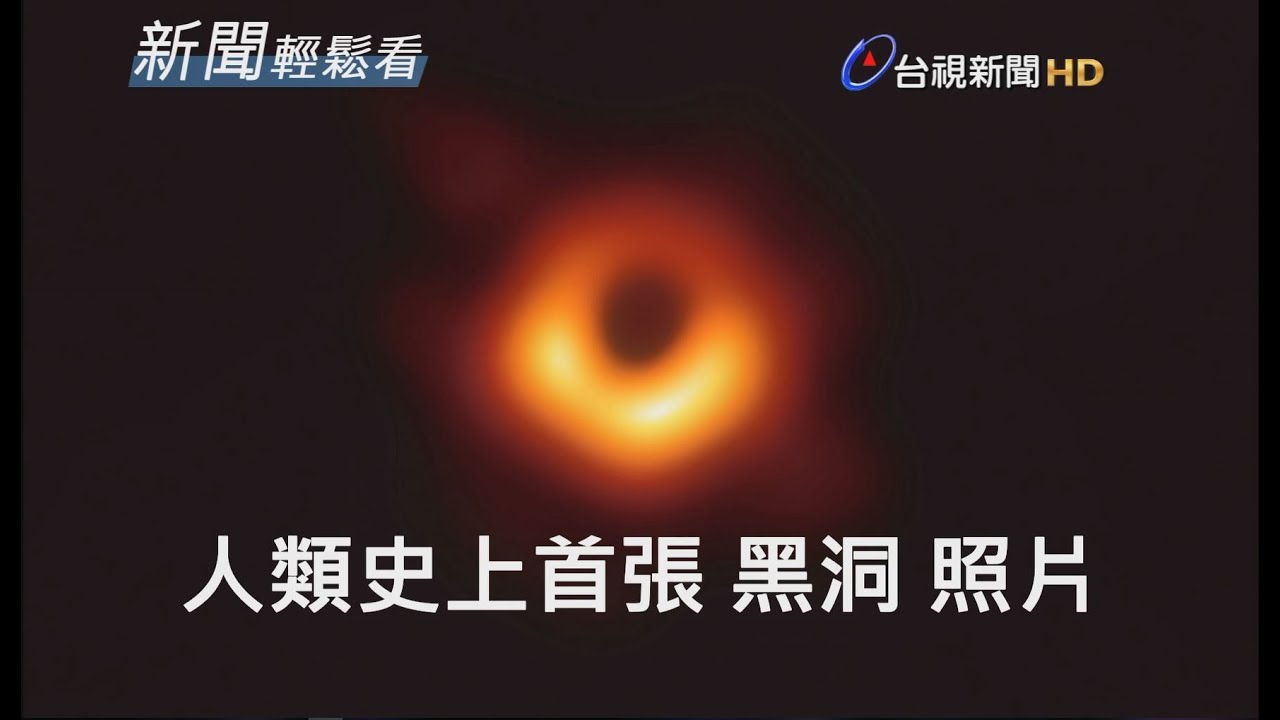
研究人員於 2019 年首次將 5500 萬光年之外黑洞的照片拼湊出來,使用的程式語言也是 Python。
1.2.2. Guido van Rossum 自己的說法
1989 年 12 月,我正在尋找一個「興趣使然」的程式設計專案,好讓我在聖誕節前後那一週能有事可做。
我的辦公室(位於阿姆斯特丹的一間政府研究實驗室)那段期間會關門,
不過我在家裡有一台電腦,手頭上也沒什麼其他事情。
於是我決定動手寫一個我最近一直在構想的新 Script 語言的直譯器:
一個 ABC 語言的後裔,能夠吸引 Unix/C 駭客的注意。
我為這個專案取了個工作名稱叫 *Python*,
當時的我心情略帶戲謔,也因為我是《Monty Python’s Flying Circus》的超級粉絲。
原文:
…in December 1989, I was looking for a "hobby" programming project that would keep me occupied during the week around Christmas.3
My office (a government-run research lab in Amsterdam) would be closed, but I had a home computer, and not much else on my hands. I decided to write an interpreter for the new Script language I had been thinking about lately: a descendant of ABC that would appeal to Unix/C hackers.
I chose Python as a working title for the project, being in a slightly irreverent mood (and a big fan of Monty Python's Flying Circus). 4
2. Python 環境建置
目前 Python 已經成為一種非常流行的程式語言,Linux 多半已內建 Python 直譯器(interpreter),Windows 與較新的 macOS 則需要自行安裝;裝好之後,你就可以直接在終端機或命令列中執行 Python 程式碼。但為了方便撰寫與測試 Python 程式碼,通常我們會使用一些整合開發環境(IDE)來撰寫程式碼,這些 IDE 通常會提供語法高亮、程式碼補全、除錯工具等功能,讓我們更容易撰寫與測試程式碼。
除了在單機上執行 Python 程式外,還有許多線上 IDE 也支援 Python 程式的撰寫與執行,這些線上 IDE 通常不需要安裝任何軟體,只要有網路連線就可以使用。最有名的線上 IDE 包括 Google Colab、Jupyter Notebook 等。
2.1. 單機環境建置
當你寫好了一支 Python 程式(如下圖)
1: print('Hello world!')
2: print('我要開始來學習Python')
這段就是 Python 的程式碼,但很可惜的,電腦其實看不懂這段程式碼,此時就需要一個「翻譯」來把這段程式「翻」成電腦看的懂的語言(機器碼),這就是 Python 直譯器在做的事。
Linux 多半已內建 Python 直譯器;Windows 從來沒有內建,macOS 從 12.3 起也不再內建,這兩種系統請到官網去下載安裝程式。
有了 Python 直譯器之後,你就可以開始撰寫如上面的 Python 程式了,但是要用什麼軟體來撰寫程式碼呢?這就是我們所說的整合開發環境(Development Environment)。
如上所述,既然 Python 程式碼就只是一些文字,那麼我們可以用任何文字編輯器來撰寫程式碼,像是 Windows 的記事本、MacOS 的 TextEdit…(如下圖,但,相信我,這不會是什麼好主意 QQ)。
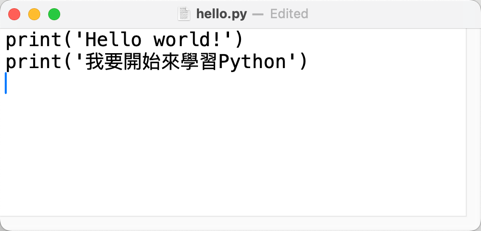
Figure 3: 以 MacOS 裡的 TextEdit 撰寫 Python 程式
使用上面這種純文字編輯器來撰寫程式碼有幾個缺點:
- 沒有執行環境:需要手動切換到終端機或命令列來執行程式碼,操作不便。
- 沒有語法高亮:程式碼中的關鍵字、變數等不會有顏色區分,閱讀起來不夠清晰。
- 沒有程式碼補全:當你輸入程式碼時,沒有自動補全功能,容易打錯字。
- 沒有除錯工具:如果程式碼有錯誤,沒有提示或建議,除錯過程會很麻煩。
這其中最顯著的缺點就是沒有執行環境,這意味著你必須先將程式碼存成檔案,然後再到終端機或命令列中執行。例如你寫完上面的程式後,就要再打開終端機或命令列,然後輸入以下指令來執行程式碼:
1: python3 hello.py
然後你就會看到終端機或命令列中顯示出程式的輸出結果:
Hello world!
我要開始來學習Python
這樣的操作雖然可以完成程式的執行,但對於初學者來說,操作起來會有點麻煩,尤其是當你需要不斷修改程式碼並重新執行時。所以就有了更方便的方式來撰寫與執行 Python 程式碼,那就是使用整合開發環境(IDE)。
2.1.1. IDE
雖然我們可以用一般的文字編輯器來寫程式,但正所謂「工欲善其事、必先利其器」,有更好的工具可用,我們為什麼要將就用一些勉強堪用的工具呢?
程式設計師是一群非常 懶惰 重視工作效率的人類,他們可以用五年來開發一個工具,只是為了將來的工作能節省五分鐘,於是這世界就存在了一些專門用來輔助程式設計師寫程式的應用程式。
但是如果只是把它叫做「寫程式的程式」,一來整個格調就沒了,二來還要先解釋哪個是名詞哪個是動詞。
於是,聰明的程式設計師給它取了一個聽起來比較厲害的名字: 整合式開發環境(Integrated Development Environment, IDE)。
市面上常見的、可以拿來寫 python 的 IDE 有以下幾種:
Visual Studio Code
這是一個由微軟開發的免費開源編輯器,支援多種程式語言,包括 Python。它提供了強大的擴充功能,可以安裝各種插件來增強功能,如語法高亮、程式碼補全、除錯工具等。如果你有 GitHub copilot 的話,還可以使用它來自動補全程式碼。官網: https://code.visualstudio.com/
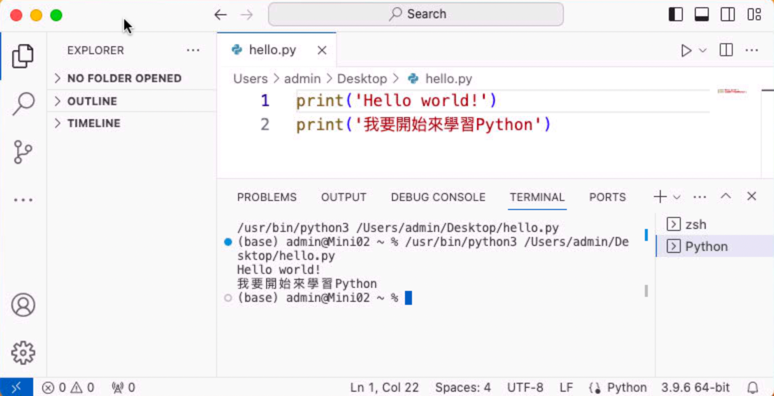
Figure 4: 以 Visual Studio Code 撰寫 Python 程式
PyCharm
PyCharm 是 JetBrains 公司開發的一款專門用於 Python 開發的 IDE。它提供了強大的功能,如語法高亮、程式碼補全、除錯工具、版本控制等。PyCharm 有免費的社群版和付費的專業版,社群版已經足夠用來學習和開發 Python 程式。官網: https://www.jetbrains.com/pycharm/
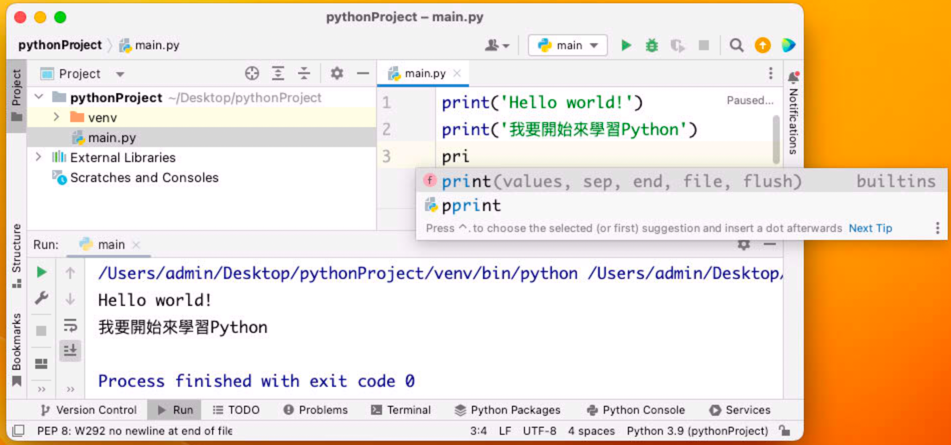
Figure 5: 以 PyCharm 撰寫 Python 程式
Emacs
Emacs 是一個非常強大的文字編輯器,支援多種程式語言,包括 Python。它有一個名為 Emacs Python Mode 的套件(package),可以提供語法高亮、程式碼補全、除錯工具等功能。Emacs 的學習曲線比較陡峭,但一旦掌握了,就可以非常高效地編寫 Python 程式。官網: https://www.gnu.org/software/emacs/

Figure 6: 以 Emacs 撰寫 Python 程式
Emacs 也支援 AI 輔助撰寫程式,例如使用 Copilot 或 ChatGPT 等 AI 工具來自動補全程式碼,這樣可以大大提高編寫程式的效率。例如:

Figure 7: 以 Emacs 與 Copilot 撰寫 Python 程式
如果你是那種需要把程式寫在文件裡的學習者,Emacs 也有一個名為 Org-mode 的 package,可以讓你在 Emacs 中撰寫文件、程式碼和筆記,並且可以直接執行程式碼。這樣你就可以在同一個環境中完成所有的工作,非常方便。
例如底下這段程式碼就是在 Emacs 的 Org-mode 中撰寫的,並且可以直接執行程式碼,輸出結果也會顯示在文件中。
1: a = 3
2: b = 4
3: c = 5
4: # 計算三角形面積
5: def area_of_triangle(a, b, c):
6:     s = (a + b + c) / 2
7:     return (s * (s - a) * (s - b) * (s - c)) ** 0.5
8:
9: print("三角形的面積為:", area_of_triangle(a, b, c))
三角形的面積為: 6.0
Emacs Org-mode 的程式編寫環境如下圖所示:

Figure 8: Emacs Org-mode 中的 Python 程式編寫環境
事實上,早在 1980 年代,Emacs 就已經是一個非常強大的編輯器了,它支援多種程式語言的編輯和執行,並且有許多插件可以擴展其功能,許多使用者甚至認為 Emacs 是一個擁有編輯器功能的作業系統,其彈性與強大功能由此可見。在當時能與 Emacs 對抗的編輯器只有 Vim:Vim 號稱「編輯器之神」;而 Emacs 則是「神的編輯器」,兩者的粉絲經常互相爭論誰才是最好的編輯器。

Figure 9: Vim, Emacs v.s. nano
聽起來很完美是吧,但是要當神是要付出代價的,Emacs 的學習曲線非常陡峭,需要花費大量時間來學習和適應它的操作方式。Emacs 的操作方式與其他編輯器有很大的不同,它使用了許多快捷鍵和命令,這些快捷鍵和命令需要花時間去記憶和練習。以下是典型的幾種文字編輯器學習曲線比較圖:

Figure 10: Emacs 與其他編輯器的學習曲線比較
天下沒有白吃的午餐,Emacs 除了學習曲線非常陡峭,許多操作都需要大量的複合按鍵(例如 Ctrl-x Ctrl-f),這對於初學者來說可能會感到困惑和不便。此外,Emacs 的界面也比較簡單,沒有像其他 IDE 那樣的圖形化界面,這可能會讓一些使用者感到不習慣,需要花費大量時間來學習和適應它的操作方式。
所以,如果你是初學者,還是建議先從其他 IDE 開始學習,等到閒著沒其他事可做了再來浪費時間研究 Emacs 吧。畢竟根據 PYPL(PopularitY of Programming Language)的統計,目前 Emacs 的市佔率僅有 0.15%,排名第 16 位,而 Visual Studio 與 Visual Studio Code 則分列前兩名,市佔率分別是 30%、16%6。

Figure 11: PYPL IDE Index
2.2. 線上 IDE/直譯器
前述的 IDE 一來要下載、二來要安裝,對於初學者來說委實有點麻煩,於是腦筋動的快的商人就看到了這個商機,把 IDE 做成了網頁服務的型式,如此一來只要能上網就可以寫程式了,只要能克服手機或平板的輸入,你甚至可以在這些裝置上寫程式。
這些線上 IDE 通常提供了 Python 直譯器,可以直接在瀏覽器中撰寫和執行 Python 程式碼,並且支援多種 Python 版本。以下是一些常見的線上 IDE:
2.2.1. Online-Python
這是一個線上 Python 編輯器和執行環境,提供了簡單易用的介面,可以直接在瀏覽器中撰寫和執行 Python 程式碼。它支援多種 Python 版本,並且可以儲存程式碼到雲端。官網: https://www.online-python.com/
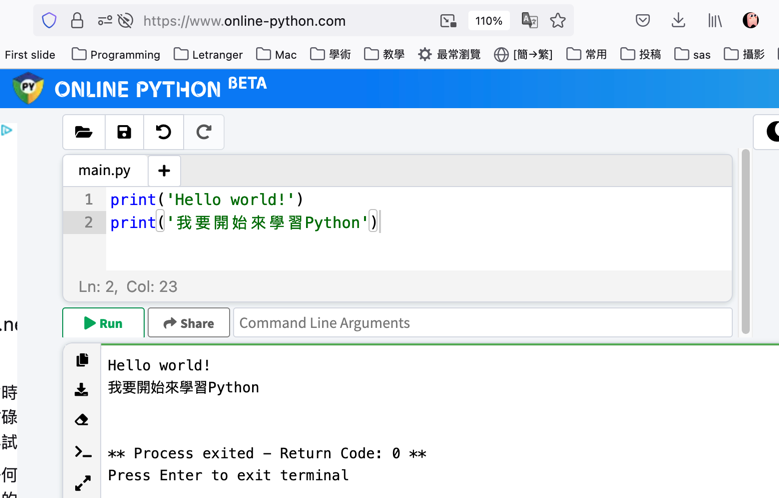
Figure 12: 以 Online Python 撰寫 Python 程式
2.2.2. Google Colab
Google Colab 是 Google 提供的一個線上 Jupyter Notebook 環境,可以用來撰寫和執行 Python 程式碼。它支援多種 Python 版本,並且可以使用 Google Drive 儲存程式碼和資料。Colab 還提供了 GPU 和 TPU 支援,可以用來加速深度學習模型的訓練。如果你是 AI 的初學者,Colab 絕對是你的首選,因為它提供了許多現成的範例和教學資源,可以幫助你快速入門。Colab 還支援與其他 Google 服務的整合,如 Google Sheets、Google Drive 等,可以方便地存取和處理資料。官網: https://colab.research.google.com/。
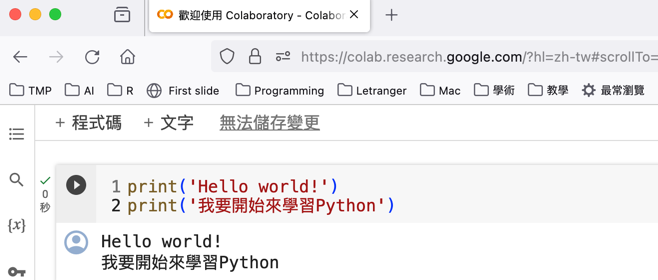
Figure 13: 以 Google Colab 撰寫 Python 程式
3. 輸出
為什麼要寫程式?不外乎是想解決某些問題,而最終的結果應如何呈現?也許是機械做出某些動作、發出某些聲音、創作出一幅圖畫、輸出一篇文章、讓 ESP32 控制一個機器人、或是讓 Raspberry Pi 控制一個燈泡等等,這些都是輸出(output)的方式。輸出可以是任何形式的結果呈現,甚至是將資料存入檔案或資料庫中,或是將資料傳送到其他裝置或系統中。
以上這些都屬於輸出,而最常見的輸出就是將結果以文字形式呈現在電腦螢幕上,在 C++,我們可以用 cout 或 printf() 來達成這個目的,在 Python 則是 print()。
3.1. 基本輸出
3.1.1. C/C++
1: #include <iostream>
2: using namespace std;
3: int main() {
4:   cout << "Hello world!";
5: }
Hello world!
3.1.2. Python
輸出文字時,前後加上"或是'
在 Python 中,輸出文字時可以使用單引號(')或雙引號(")來包裹文字,這樣就可以讓 Python 直譯器知道這是一段文字,而不是變數或其他語法。
1: print("Hello world!")
Hello world!
也可以輸出數字或運算式
在 Python 中,print() 函式可以輸出任何類型的資料,包括數字、運算式等。當輸出數字時,Python 會自動將其轉換為字串形式。
1: print(3.1415)
2: print(10*10*3.1416)
3: print((1+3)/20)
上面那段程式碼會輸出以下結果:
3.1415
314.15999999999997
0.2
print() 在輸出時,會把數字轉成文字顯示在螢幕上,但變數本身的型態並不會改變。也就是說,執行 print(3.1415) 之後,3.1415 在 Python 裡仍然是浮點數(float),不會因為被 print 出來就變成字串。
print()裡可以用逗號連接不同類型的資料
在 Python 中,print() 函式可以接受多個參數,如果使用逗號來連接不同類型的資料,在輸出時會自動加上空格作為分隔符號。
1: print('半徑為',10,'的圓,其面積為:',10*10*3.14)
請留意如下輸出中的 10,其前後有空格,這是因為 在上面的程式中,print() 函式使用了逗號作為分隔符號。
半徑為 10 的圓,其面積為: 314.0
多個指令也可以寫在一行
但要以分號間隔(是的,像 C/C++那樣….)
1: print("hi"); print("how are you?")
hi
how are you?
3.2. 進階輸出
3.2.1. 語法
- print( 項目 1, [ 項目 2, … , sep = 分隔字元 , end = 結束字元 ] )
- sep (分隔字元) 預設為空白字元
- end (結束字元) 預設為換行字元
\n
3.2.2. 範例
 1: a, b, c = 5, 10, 20
 2: print(a, b, c)
 3: print('完全不呈現預設的空白: ',a, b, c, sep ='')
 4: print('以逗號來當分隔符號: ',a, b, c, sep =',')
 5: print('==測試end的用法1==')
 6: print(a, end='\n') #end預設值為跳行,這和 print(a)是一樣的
 7: print(b, end='\n')
 8: print(c, end='\n')
 9: print('==測試end的用法2==')
10: print('不進行跳行: ', a, end=' ')
11: print(b, end=' ')
12: print(c, end=' ')
5 10 20
完全不呈現預設的空白: 51020
以逗號來當分隔符號: ,5,10,20
==測試end的用法1==
5
10
20
==測試end的用法2==
不進行跳行:  5 10 20
留意上面第二行的輸出:當 sep='' 時,print() 會把 所有 參數之間的分隔都拿掉,所以字串 '完全不呈現預設的空白: ' 和後面的 5、10、20 全部黏在一起變成了 完全不呈現預設的空白: 51020 。而第三行 sep=',' 時,逗號也會插在字串參數和數字參數之間,所以才會出現 以逗號來當分隔符號: ,5,10,20 (注意冒號後面緊接著一個逗號)。
3.2.3. 跳脫字元
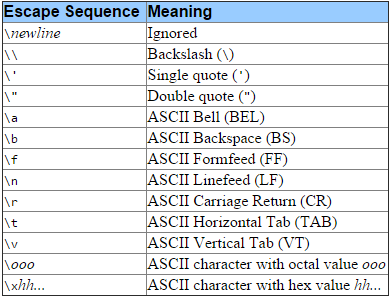
Figure 14: Escape char
所謂跳脫字元(escape character),就是在字串中使用特殊符號來表示一些特殊的字元,例如換行符號( \n )、tab 符號( \t )、單引號(\')、雙引號(\")等。這些特殊符號可以讓我們在字串中包含一些無法直接輸入的字元。
在 Python 中,跳脫字元通常以反斜線(\)開頭,後面跟著一個或多個字元。
如果要輸出單引號(')或雙引號("),除了使用跳脫字元(\),也可以利用單引號、雙引號互換的作法,如下例:
1: #使用跳脫字元\
2: print("他說:\"好,我試試!!\",然後他就逝世了。")
3: #外層使用單引號
4: print('他說:"好,我試試!!",然後他就逝世了。')
5: #單引號、雙引號互換的作法
6: print("他說:'好,我試試!!',然後他就逝世了。")
他說:"好,我試試!!",然後他就逝世了。
他說:"好,我試試!!",然後他就逝世了。
他說:'好,我試試!!',然後他就逝世了。
- 進階閱讀: CRLF、CR、LF詳解
3.2.4. 課堂練習
請以 print()輸出以下文字
Your brain has two parts: the left and the right.
Your left brain has nothing "right", and your right brain has nothing "left".
3.3. f-string
f-string 是 Python 3.6 以後新增的字串格式化方法,它可以讓我們在字串中直接嵌入變數,並且可以控制輸出的格式。f-string 的語法是以字母 f 開頭,然後在字串中使用大括號({})來包裹變數或表達式。
由於 f-string 轉換時會做最佳化,其速度會比下一節介紹的 format() 與 % 寫法稍稍快一點。
3.3.1. 輸出一個數字,不控制格式
1: score = 83
2: print(score)
3: print(f'{score}')
83
83
3.3.2. 輸出一個數字並控制輸出到小數點第二位
1: height = 168.3
2:
3: print(f'{height:.2f}')
4: # 加入文字
5: print(f'身高為:{height:.2f}')
168.30
身高為:168.30
3.3.3. 輸出兩個變數並控制輸出格式
1: weight = 65.33
2: height = 168.33
3: # 不跳行,加逗號
4: print(f'{height:.2f}, {weight:.3f}')
5: # 跳行
6: print(f'{height:.2f}\n{weight:.3f}')
7: # 跳行並加入說明文字
8: print(f'身高:{height:.2f}\n體重:{weight:.3f}')
168.33, 65.330
168.33
65.330
身高:168.33
體重:65.330
3.3.4. 輸出三個不同型別的變數
1: name = 'Vanessa'
2: height = 165
3: weight = 52.3
4: print(f'{name}的身高是{height}公分、體重是{weight:.2f}公斤')
Vanessa的身高是165公分、體重是52.30公斤
3.3.5. 如何控制輸出字串的靠齊方向
和數字輸出一樣,我們可以預留一些空間給文字輸出,並控制文字的靠齊方向,例如
- {:>}: 向右靠
- {:<}: 向左靠
- {:^}: 置中對齊
下例中我們預留了 8 個空格來顯示姓名(name) ,並要求向右對齊
1: name1 = 'James'
2: name2 = 'Vanessa'
3: height1 = 165
4: weight1 = 52.3
5: height2 = 175
6: weight2 = 72.3
7: print(f'{name1:>8}的身高是{height1:>6}公分、體重是{weight1:10.2f}公斤')
8: print(f'{name2:>8}的身高是{height2:>6}公分、體重是{weight2:10.2f}公斤')
  James的身高是   165公分、體重是     52.30公斤
Vanessa的身高是   175公分、體重是     72.30公斤
3.3.6. f-string 常用格式速查
以下整理幾個最常用的格式規格,方便查閱:
| 寫法 | 說明 | 範例結果 |
|---|---|---|
f'{x:.2f}' |
小數點後 2 位 | 3.14 |
f'{x:>10}' |
靠右對齊,寬度 10 | ␣␣␣␣␣hello |
f'{x:<10}' |
靠左對齊,寬度 10 | hello␣␣␣␣␣ |
f'{x:^10}' |
置中對齊,寬度 10 | ␣␣hello␣␣␣ |
f'{x:05d}' |
補零至 5 位整數 | 00042 |
f'{x:+d}' |
強制顯示正負號 | +42 / -42 |
f'{x:,}' |
千分位逗號 | 1,234,567 |
f'{x:.2%}' |
百分比格式(乘 100 加 %) | 31.42% |
3.4. 其他格式化輸出方法
前面介紹的 f-string 是目前最推薦的格式化方式,但 Python 的歷史上還有其他幾種格式化方法。雖然現在寫新程式建議優先用 f-string,但你在網路上搜尋範例、閱讀別人的程式碼(尤其是比較早期的專案或教學)時,一定會看到以下這些寫法,所以還是有必要認識一下。
3.4.1. 格式化輸出: format() (新版)
format() 是 Python 2.6/3.0 以後新增的字串格式化方法,它可以讓我們在字串中使用大括號({})來包裹變數,並且可以控制輸出的格式。format() 的語法是字串.format(變數 1, 變數 2, …),其中變數可以是任何類型的資料,包括數字、字串、列表、字典等。
- 語法
- format 格式化輸出語法:print(字串.format(變數))
- 字串裡以{0}、{1}、… 來對應參數列裡的變數
- 格式控制:print('{0:控制字串}'.format(參數))
- format 格式化輸出語法:print(字串.format(變數))
3.4.2. format()輸出範例
輸出一個數字,不控制格式
1: score = 83
2: print(score)
3: print('{}'.format(score))
83
83
輸出一個數字並控制輸出到小數點第二位
1: height = 168.3
2:
3: print('{0:.2f}'.format(height))
4: # 上一行{}中的0代表該處要輸出format()中的第0個變數,只有一個時也可以省略
5: print('{:.2f}'.format(height))
6:
7: # 加入文字
8: print('身高為:{:.2f}'.format(height))
168.30
168.30
身高為:168.30
輸出兩個變數並控制輸出格式
1: weight = 65.33
2: height = 168.33
3: # 不跳行
4: print('{0:.2f}{1:.3f}'.format(height, weight))
5: # 跳行
6: print('{0:.2f}\n{1:.3f}'.format(height, weight))
7: # 跳行並加入說明文字
8: print('身高:{0:.2f}\n體重:{1:.3f}'.format(height, weight))
168.3365.330
168.33
65.330
身高:168.33
體重:65.330
輸出三個不同型別的變數
1: name = 'Vanessa'
2: height = 165
3: weight = 52.3
4: print('{0}的身高是{1}公分、體重是{2:.2f}公斤'.format(name, height, weight))
Vanessa的身高是165公分、體重是52.30公斤
如何控制輸出字串的靠齊方向
和數字輸出一樣,我們可以預留一些空間給文字輸出,並控制文字的靠齊方向,例如
- {:>}: 向右靠
- {:<}: 向左靠
- {:^}: 置中對齊
下例中我們預留了 8 個空格來顯示姓名(name) ,並要求向右對齊
1: name1 = 'James'
2: name2 = 'Vanessa'
3: print('My name is {0:>8}. Nice to meet you.'.format(name1))
4: print('My name is {0:>8}. Nice to meet you.'.format(name2))
My name is    James. Nice to meet you.
My name is  Vanessa. Nice to meet you.
3.4.3. 格式化輸出: Template
Template 是 Python 2.4 以後新增的字串格式化方法,它可以讓我們在字串中使用 $ 符號來標示變數。用法分兩步:先以 Template('含 $變數 的字串') 建立樣板,再呼叫 substitute(變數=值) 把值帶入,如下例:
1: from string import Template
2:
3: name = 'TNFSH'
4: tmp = Template('Hello, $who')
5: print(tmp.substitute(who = name))
6:
Hello, TNFSH
3.4.4. 格式化輸出: % (舊版)
% 是 Python 2.x 版本的字串格式化方法,它可以讓我們在字串中使用百分號(%)來包裹變數,並且可以控制輸出的格式。% 的語法是字串 % (變數 1, 變數 2, …),其中變數可以是任何類型的資料,包括數字、字串、列表、字典等。
- 語法
- 格式化輸出語法:print( 字串 %(參數) )
- 字串裡 %s 代表字串、%d 代表整數、%f 代表浮點數
- 格式化輸出語法:print( 字串 %(參數) )
範例
1: name = '台北101'
2: height = 508
3: fee = 18.24
4: print('%s的高度為%d公尺,參觀門票為%8.2f美金.' %(name, height, fee))
5: print('%s的高度為%d公尺,參觀門票為%0.2f美金.' %(name, height, fee))
台北 101 的高度為 508 公尺,參觀門票為   18.24 美金.
台北 101 的高度為 508 公尺,參觀門票為 18.24 美金.
4. 變數
想法: 讓底下的程式碼更有彈性些,可以算任何的半徑值….
1: print('半徑為',10,'的圓,其面積為:',10*10*3.14)
以變數來儲存半徑
1: r = 10
2: print('半徑為',r,'的圓,其面積為:',r*r*3.14)
3: r = 20
4: print('半徑為',r,'的圓,其面積為:',r*r*3.14)
5: r = 30
6: print('半徑為',r,'的圓,其面積為:',r*r*3.14)
變數是一種用來儲存資料的容器,它可以讓我們在程式中使用這些資料,而不需要每次都重新計算或輸入。變數可以儲存任何類型的資料,包括數字、字串、列表、字典等。
4.1. 變數的指派(assign)
- 指派(assign)是將一個值(或運算式)指派給一個變數的過程。
- 和 C/C++不同,Python 變數不需宣告,依指派值自動設定資料型態(dynamically typing)。
語法
變數名稱 = 指派值
- 變數不再使用時,可用 del 指令將其刪除,以節省記憶體。
- 範例:
 1: a = 5
 2: b = 3.14
 3: c = 'TNFSH'
 4: a = b = c = 10
 5: a += 1 # 相當於 a = a + 1,還有 -=, *=, /=
 6: name, number = 'TNFSH', 35 # 多個變數一同指派
 7: quotient, mod = divmod(10, 3)
 8: print(quotient)
 9: print(mod)
10: del c
11: print(name)
12: # swap交換兩個變數的值
13: print(a, b)
14: a, b = b, a
15: print(a, b)
3
1
TNFSH
11 10
10 11
變數,顧名思義,它的儲存內容會改變,所以有時我們會看到這種在數學定義中看起來矛盾的運算式
1: a = 3
2: a = a + 10
這是因為等號(=)的意思是指定,而且 Python 的直譯器會先將=右側的結果運算出來,再將結果 assign 給=左側的變數
- 先看看以下的程式碼(複製程式碼、貼到你的編輯器上)
- 再猜一猜執行結果
- 最後再執行,看看你有沒有猜對
1: score = 10
2: score = score + 5
3: score = score * 6
4: print(score)
4.2. 變數的命名規則
和 C/C++一樣的,變數的命名規則如下:
- 由英文、數字、底線、中文(不建議)組成
- 不得以數字開頭
- 不能與 Python 內建的保留字相同
4.2.1. 範例
| Example | ✓ / × |
|---|---|
| abc_123 | ✓ |
| 3pigs | × |
| Happy New Year | × |
| class | × |
| Good! | × |
4.3. 變數的各種資料型態
Python 的變數型態是動態的(dynamically typed),這意味著在程式執行時,變數的型態可以隨時改變。Python 會根據變數所儲存的值自動判斷其型態,而不需要在宣告變數時指定型態。
4.3.1. 變數型態的判斷: type()
既然是動態的,那麼我們如何知道變數的型態呢?Python 提供了 type() 函式來判斷變數的型態。
1: print(type(2020))
2: print(type(3.1416))
3: print(type('Hello world'))
<class 'int'>
<class 'float'>
<class 'str'>
可以看到,type() 會告訴你這個值是什麼型態:int 代表整數、float 代表浮點數(小數)、str 代表字串。
4.3.2. 常用類型
常用的資料型態有:
- 整數: int
- 浮點數: float
- 布林值(True / False): bool, T 與 F 要大寫。布林值只有兩個:
True和False,通常用在條件判斷中(例如 if 的條件式結果就是一個布林值)。注意:Python 的 True/False 首字母大寫,和 C/C++ 的 true/false 不同。 - 字串: str, 以'或"含括,若輸出字串要包含引號,則以另一種引號含括該字串,或是在前面加上跳脫字元(\)。
1: age = 18
2: weight = 67.87
3: good_words = " 請常說'請'、'謝謝'、'對不起' "
4: other_words = "請常說\"請\"、\"謝謝\"、\"對不起\""
5: print(type(age))
6: print(type(weight))
7: print(type(good_words))
8: print(other_words)
<class 'int'>
<class 'float'>
<class 'str'>
請常說"請"、"謝謝"、"對不起"
- 序列型態: list, tuple
- 集合型態: set
- 對映型態: dict
4.3.3. 型態轉換
在 Python 中,變數的型態可以隨時轉換,這稱為型態轉換(type conversion)。Python 提供了幾個內建函式來進行型態轉換,例如 int()、float()、str() 等。
- 自動轉換
1: score = 60
2: print(type(score))
3: score = score + 3.5       # 自動轉換為浮點數,結果為63.5
4: print(type(score))
<class 'int'>
<class 'float'>
- 強制轉換
1: score = int(30.22)        # 將括弧內的資料轉換為整數
2: score = float(score)      # 將括弧內的資料轉換為浮點數
3: test = str(score)# 將括弧內的資料轉換為字串
5. 輸入
在上一個版本的程式中,我們使用變數來儲存半徑的值,這樣就可以讓程式更有彈性,可以計算不同半徑的圓面積。但是,這樣還是需要我們手動修改程式碼中的變數值,才能計算不同半徑的圓面積:
想法: 讓前一版的程式更有彈性
1: print('半徑為',10,'的圓,其面積為:',10*10*3.14)
如果我們可以讓 使用者 在 每次執行程式時 輸入半徑的值,那麼程式就可以自動計算不同半徑的圓面積,而不需要修改程式碼。這就是輸入(input)的概念。
請試著執行以下程式碼,看看它的輸入與輸出結果:
1: r = input()
2: print('半徑為',r,'的圓,其面積為:',r*r*3.14)
如果你執行了上面的程式碼,你會發現程式在執行到 r*r*3.14 時就 crash 了,並出現類似如下的錯誤訊息:
TypeError: can't multiply sequence by non-int of type 'str'
這是因為 input() 讀入的資料型態是 字串(str) ,程式會先計算 r*r ,而兩個字串是不能相乘的(字串同樣不能和浮點數相乘)。即使你輸入的是數字 10,Python 也會把它當成字串 '10' 來處理。
要解決這個問題,我們需要將輸入的值轉換為數字型態。Python 提供了 int() 和 float() 函式來將字串轉換為整數或浮點數。以下是修正後的程式碼:
1: r = input()
2: r = int(r)
3: print('半徑為',r,'的圓,其面積為:',r*r*3.14)
上述程式中的前兩行也可以寫成一行
1: r = int(input())
2: print('半徑為',r,'的圓,其面積為:',r*r*3.14)
5.1. 輸入/input(): 基本輸入與型別轉換
Python 使用 input() 函式來讀取使用者輸入的資料。這個函式會等待使用者輸入一行文字,然後將這行文字作為字串傳回。需要注意的是,input() 函式讀取的資料型態是字串(str),如果需要其他型別的資料,需要進行型別轉換。
5.1.1. 語法/範例
語法
1: variable = input([提示字元])
- PS: 經由 input( )函式讀入的資料,其資料型態皆為字串
- 如果你在語法中看到[],表示這個參數是可選(optional)的,可以省略。
範例
1: a = input('輸入國文成績:')
2: b = input('輸入數學成績:')
3: c = input()
4: print(f'三科成績分別為 {a} {b} {c}')
5.1.2. 輸入搭配型別轉換
1: a = int(input('輸入國文成績:'))
2: b = int(input('輸入數學成績:'))
3: c = int(input())
4: print(f'總分為{a+b+c}')
5.2. 進階輸入處理
python 的 input()函數每次讀入一行資料,直到換行為止,但如果這行資料裡就包含了許多變數,那就應該先把字串切割(split())成許多子部份,然後視需要另做型別轉換。
5.2.1. split() 語法
1: input().split(separator, maxsplit)
- separator(可選):分隔符號,字串會在指定的分隔符號處被切割。如果沒有指定,預設以任何空白字元(空格、換行等)作為分隔符號。
- maxsplit(可選):最多切割幾次。預設值為 -1,表示不限制切割次數。
- 回傳值:split() 會回傳一個由切割後的子字串所組成的 list。
5.2.2. 適用狀況
假設我們面對兩種不同的資料輸入方式:
狀況一:輸入的資料為三個成績同時寫在一行(以空白分隔)
1: 23 45 66狀況二:三個成績分為三列(每次都按 enter)
1: 23
2: 45
3: 66
對 C/C++來說,這並不是什麼特別的問題,上述兩種狀況都可以用三個 cin 將成績讀進程式:
1: #include <iostream>
2: using namespace std;
3: int main() {
4:     int a, b, c;
5:     cin >> a >> b >> c;
6: }
但是對 python 來說,如果針對狀況一的資料以下列方式讀入
1: scoreX = input() #一次把整列資料讀完
2: scoreY = input() #沒資料可以讀
3: scoreZ = input()
則 scoreX 的值會變成字串'23 45 66',而 scoreY, scoreZ 會沒有值,因為這行裡的所有資料全部被讀入 scoreX 中。
5.2.3. 解決方案
作法 1:
讀入整行字串後,
再以字串分割處理,最後將分割後的字串分別 assign 給不同的變數。例如已知第一行有三個值,則可以先準備好三個變數來儲存被 split 切割後的三個值
1: scoreX, scoreY, scoreZ = input().split()
作法 2:
先把這段輸入存成一個字串變數(inp),再對這個變數做 split,從這裡我們也可以隱約了解 split()這個 function 是 字串變數 專屬的 function(split()是 python 字串的切割 function,進階閱讀)。
1: inp = input() #先把輸入的字串存到字串變數inp裡
2: a, b, c = inp.split() #再用split()去切割inp字串,
3: # 依此類推逐一取得輸入值
4: a = int(a)
5: b = int(b)
6: c = int(c)
作法 3:
也可以用一個 list 來儲存所有被 split 切割的值,最後再由 list 來取得值(詳見本章 資料型別 中的 串列 List )
作法 4:
利用 map() 函式一次把所有切割出來的字串批量轉成整數。 map(函式, 序列) 的意思是「把這個函式套用到序列中的每一個元素上」,所以 map(int, input().split()) 就是把 split() 切出來的每個字串都套用 int() 轉成整數。
1: scoreX, scoreY, scoreZ = map(int, input().split())
上面這行做了三件事:
input()讀入一整行字串,例如23 45 66.split()把字串以空白切割成 =['23', '45', '66']map(int, ...)把每個字串元素都用 int() 轉成整數,最後分別 assign 給 scoreX、scoreY、scoreZ
map() 小檔案
- 語法:
map(function, iterable)- 把 function 套用到 iterable(如 list、tuple)的每一個元素上
- 回傳的是 map 物件(迭代器),不是 list,所以通常要用
list()轉換- function 可以是內建函式(如
int、str)或自定義函式(包括lambda,後面會介紹)
作法 5:
在一行輸入不定個數的整數,且不確定到底有幾個數字時,可以用 list comprehension(串列生成式)來處理:
1: a = [int(x) for x in input().split()]
- 得到的 a 為 int list
- 這行的意思是:「對 input().split() 切出來的每個元素 x,都做 int(x) 轉換,然後把所有結果收集成一個 list」
- 可以想像為數學的集合表示法 \(S = \{int(x) \mid x \in input().split()\}\)
- 這種寫法叫做 list comprehension,會在後面的 List 章節中詳細介紹,現在先知道怎麼用就好
6. try-except 例外處理
測試一下底下的程式:
1: import math
2: instr = input() #輸入a9
3: score = float(instr) #出問題了
4:
5: score = math.sqrt(score)*10
6: print(f'{score:.4f}')
如果你輸入了 10,程式會輸出 31.6228(即 \(\sqrt{10} \times 10\) ),但如果你輸入了 a9,程式就會 crash 掉,因為 Python 無法將字串 'a9' 轉換成浮點數(程式第 3 行的 float(instr) ),也因此變數 score 無法被賦值(assign value)。此時程式就會發生錯誤並停止執行,並出現類似如下的錯誤訊息:
Traceback (most recent call last):
  File "main.py", line 3, in <module>
    score = float(instr)
ValueError: could not convert string to float: 'a9'
對於寫程式的人來說,這樣的錯誤雖然常見,而且明顯是因為使用者的輸入錯誤所導致,但
使用者永遠是對的
程式執行到當掉是不允許的
為了避免發生這種情況,Python 提供了 try-except 機制來處理可能發生的錯誤。這樣可以讓程式在遇到錯誤時不會直接崩潰,而是可以給使用者一個友好的提示或進行其他處理。
- 大部分執行中的錯誤, Python 直譯器 (interpreter) 會以發起例外 (exception) 的方式來中斷程式的執行。
- 凡是可能會產生例外的程式碼, Python 利用 try-except 陳述 (try-except statement) 讓程式設計師自行處理例外。 try-except 為關鍵字 (keyword) 之一,專門用來例外處理 (exception handling) 的。
- 進階: Python Try Except
6.1. 解決上述問題
為了解決上述問題,我們可以使用 try-except 來捕捉可能發生的錯誤,並給出適當的提示。以下是修改後的程式碼:
 1: import math
 2:
 3: instr = input() #輸入a9
 4:
 5: try:
 6:     score = float(instr)
 7:     score = math.sqrt(score)*10
 8:     print(score)
 9: except:
10:     print("Error")
Error
在上述程式中,我們使用了 try-except 來捕捉可能發生的錯誤。如果在 try 區塊中的程式碼發生錯誤,Python 會跳到 except 區塊執行,並輸出 "Error"。這樣就避免了程式直接崩潰的情況。
6.2. 注意事項
並不是有了 try…except 就天下太平了,試著執行下列程式
1: import math
2:
3: try:
4:     score = int(input()) #輸入 xyz
5: except:
6:     print('error')
7:
8: print(math.sqrt(score))
想一下為什麼程式還是 crash 掉….
以上述程式為例,我們基本上有以下幾種解決方案:
- 在 except 區塊中加入 exit()
即,在 except 區塊中處理完錯誤(如輸出提示錯誤訊息)後,用 exit() 明確地終止程式執行(注意:return 只能用在函式裡面,這裡的程式沒有函式,寫 return 會得到 SyntaxError),以防止程式碼繼續執行到依賴於 try 區塊成功結果的部分,也就是 print(math.sqrt(score))。 - 把 print(math.sqrt(score)) 放在 try 區塊中
將所有依賴於 try 區塊中可能成功操作的程式碼(包括後續的計算和輸出),都放在 try 區塊內部。這樣,一旦 try 區塊中的任何一行程式碼引發例外,程式就會立即跳轉到 except 區塊,而不會執行 try 區塊中剩餘的、依賴於錯誤結果的程式碼。 - 把原本的 print(math.sqrt(score)) 放在一個檢查 score 是否為數字的條件判斷中
雖然可以在 except 區塊之外添加條件判斷(例如檢查 score 變數是否已定義,或者它的值是否有效),但這不是 Python 處理例外的慣用方法。Python 鼓勵使用 try-except 來處理預期之外的錯誤,而不是預先進行大量的條件檢查。 把 input()放在一個 while 迴圈中,直到使用者輸入正確的數字為止
使用 while 迴圈結合 try-except 實現一個有效的輸入驗證機制。在 try 區塊中嘗試轉換輸入,如果成功則 break 離開迴圈;如果發生錯誤,則在 except 區塊中提示使用者重新輸入,並繼續迴圈,直到輸入有效為止。這能提供更好的使用者體驗。
例如類似如下的程式架構:
1: import math
2: while True:
3:     try:
4:         score = int(input("請輸入一個整數: "))  # 輸入整數
5:         break  # 如果成功,跳出迴圈
6:     except ValueError:  # 捕捉特定的錯誤類型
7:         print("輸入錯誤,請重新輸入一個整數。")
8: print(math.sqrt(score))
6.3. 指定具體的例外類型
我們也可以在 except 後面指定具體的例外類型,這樣可以更精確地捕捉特定的錯誤。例如:
 1: import math
 2:
 3: instr = input() #輸入a9
 4:
 5: try:
 6:     score = float(instr)
 7:     score = math.sqrt(score)*10
 8:     print(score)
 9: except ValueError: # 專門捕捉 ValueError
10:     print("輸入的不是有效的數字。")
11: except TypeError: # 範例,如果 math.sqrt() 收到不兼容的類型
12:     print("數值類型錯誤,無法計算。")
13: except Exception as e: # 捕捉所有其他未預期的錯誤,並打印錯誤訊息
14:     print(f"發生了未預期的錯誤: {e}")
這樣可以根據錯誤類型給出更精確的提示。
6.4. 如何知道發生的是哪一種例外
要「點名」攔例外,前提是你得先知道發生的是哪一種例外。方法是用 except Exception as e 把例外物件接下來,再從它身上取資訊:
1: try:
2:     n = int(input())
3: except Exception as e:
4:     print(type(e).__name__)   # 只印類型名稱,例如 ValueError
5:     print(e)                  # 只印錯誤訊息,例如 invalid literal for int() with base 10: 'abc'
6:     print(repr(e))            # 類型加訊息,例如 ValueError("invalid literal for int() with base 10: 'abc'")
輸入 abc 時的輸出:
ValueError
invalid literal for int() with base 10: 'abc'
ValueError("invalid literal for int() with base 10: 'abc'")
三種寫法的差別:
type(e).__name__得到字串'ValueError',適合拿來做判斷或顯示。print(e)只有訊息文字,沒有類型。repr(e)兩者都有,最接近直譯器自己印出來的樣子。
如果想要完整的 traceback(含出錯的行號),用 traceback 模組:
1: import traceback
2: try:
3:     n = int(input())
4: except Exception:
5:     traceback.print_exc()
建議的工作流程:還不確定會出什麼錯時,先用 except Exception as e 把類型印出來看看是誰;知道了之後,再改成點名攔那個類型(例如 except ValueError: ),不要一直停留在 except Exception 或 except: 。
順帶一提,=int()= 會丟出哪一種例外,要看你餵給它什麼:
- 傳入字串但內容不是整數,例如
int('abc')、int('')、int('3.5'):ValueError(型別對,值不合法) - 傳入根本不是字串也不是數字的東西,例如
int(None)、int([1]):TypeError(型別本身就不被接受) - 不會出錯的:
int(3.7)得到 3,int(True)得到 1
因為 input() 永遠傳回字串,所以 int(input()) 只可能遇到 ValueError,不會碰到 TypeError。
6.5. try-except-else
在 Python 中,try-except 還可以搭配 else 使用。else 區塊會在 try 區塊中的程式碼沒有引發任何例外時執行。這樣可以讓我們在沒有錯誤的情況下執行一些額外的程式碼。
 1: import math
 2:
 3: instr = input()
 4:
 5: try:
 6:     score = float(instr)
 7: except ValueError:
 8:     print("輸入的不是有效的數字。")
 9: else: # 如果 try 區塊沒有發生錯誤,則執行這裡
10:     if score >= 0: # math.sqrt 不接受負數
11:         result = math.sqrt(score) * 10
12:         print(f'{result:.4f}')
13:     else:
14:         print("輸入的數字不能是負數。")
15: # 注意:如果 math.sqrt(score) 也在 try 區塊內,則不需要在這裡檢查負數
6.6. try-except-finally
finally 區塊中的程式碼無論是否發生例外都會執行。它常用於清理資源,例如關閉文件或網絡連接。
1: try:
2:     f = open("myfile.txt")
3:     # 讀取文件
4: except FileNotFoundError:
5:     print("檔案不存在。")
6: finally:
7:     if 'f' in locals() and not f.closed: # 確保 f 已定義且未關閉
8:         f.close() # 無論如何都要關閉文件
6.7. 如果有很多個變數需要檢查例外呢
也許你可以一個一個去變更資料類型,如果出問題後就 結束 程式,不要再往下執行,在 python 中,你可以透過呼叫 sys 模組中的 exit()或是 os 模組中的_exit()來終止程式,例如在 print('error')後就結束程式,詳情請自行參閱這篇。
或者,你更應該自己透過關鍵字去膜拜一下 Google 大神,例如 python stop program 之類的….
6.7.1. 提示
回顧一下一年級學 C/C++時,有提及 if 的巢狀寫法,例如
 1: #include <iostream>
 2: using namespace std;
 3: int main() {
 4:     int a, b;
 5:     cin >> a >> b;
 6:     if (a>=60) {
 7:         if (b>=60) {
 8:             cout << "all pass";
 9:         } else {
10:             cout << "第2科掛了";
11:         }
12:     } else {
13:         cout << "第1科掛了";
14:     }
15: }
你可以想一下能不能把 這種寫法套用在 try…except 上。
6.8. 進階閱讀
7. 註解
Python 的註解方式與 C/C++有些不同,Python 沒有像 C/C++ 那樣的 /* ... */ 多行註解語法,主要有以下方式:
- 單行註解:以 # 開頭,後面跟著註解內容。這是 Python 唯一正式的註解語法。
- 多行註解:可以使用三個單引號(''')或三個雙引號(""")來包裹多行內容。嚴格來說,這其實是一個多行字串(string literal),只是因為沒有被 assign 給任何變數,所以執行時會被 Python 忽略,因此常被拿來當作多行註解使用。
7.1. 語法
- 單行註解:以 # 開頭
- 多行註解:前後以 ''' 或 """ 含括(本質上是多行字串)
7.2. 範例
 1: ## 這是單行註解
 2: a = 3
 3: '''
 4: 這是多行註解
 5: LALALA
 6: '''
 7: print(a)
 8: """
 9: 這也是註解
10: 可以放多行
11: """
8. 運算元與運算式
8.1. 算術運算
Python 支援多種算術運算,以下是常用的算術運算子:
- +: 加
- -: 減
- *: 乘
- /: 除
- %: 取餘數
- //: 求商
- **: 指數
8.1.1. 算術運算範例#1
1: # python code for arithematic opearation
2: print(5+3)
3: print(5-3)
4: print(5*3)
5: print(5/3)
6: print(5%3)
7: print(5//3)
8: print(5**3)
8
2
15
1.6666666666666667
2
1
125
8.1.2. 算術運算範例#2
 1: a = int(input("input a: "))
 2: op = input("input op: ")
 3: b = int(input("input b: "))
 4:
 5: if op == '+':
 6:     ans = a + b;
 7: elif op == '-':
 8:     ans = a - b;
 9: elif op == '*':
10:     ans = a * b;
11: elif op == '/':
12:     ans = a / b;
13: elif op == '%':
14:     ans = a % b;
15:
16: print(str(a) + op + str(b) + "=" + str(ans))
17:
8.1.3. 字串運算
1: print("Python"+"基礎")
2: print(3*"Python基礎")
Python基礎
Python基礎Python基礎Python基礎
8.2. 關係運算子
Python 也支援多種關係運算子,用來比較兩個值的大小或相等性。以下是常用的關係運算子:
| 運算子 | > | < | >= | <= | == | != |
|---|---|---|---|---|---|---|
| 範例 | 大於 | 小於 | 大於等於 | 小於等於 | 等於 | 不等於 |
8.3. 邏輯運算子
當我們需要對多個條件進行邏輯運算時,可以使用邏輯運算子。Python 提供了以下邏輯運算子:
| 運算子 | and | or | not |
|---|---|---|---|
| 範例 | (a>b) and (a<c) | (a>b) or (a==b) | not (a>b) |
8.4. 複合指定運算子
如果我們需要對變數進行多次運算並更新其值,可以使用複合指定運算子。這些運算子結合了算術運算和指定運算,讓程式碼更簡潔。以下是常用的複合指定運算子:
| 運算子 | += | -= | *= | /= | %= | //= | **= |
|---|---|---|---|---|---|---|---|
| 範例 | a+=3 | a-=3 | a*=3 | a/=3 | a%=3 | a//=3 | a**=3 |
| 等價運算 | a=a+3 | a=a-3 | a=a*3 | a=a/3 | a=a%3 | a=a//3 | a=a**3 |
8.5. 指派運算子
我們最常見的指派運算子是 = ,它將右邊的值或運算式結果指派給左邊的變數。
除了 = 之外,Python 3.8 起新增了一個稱為「海象運算子」(Walrus Operator) 的 := ,因為 := 長得像海象的眼睛和長牙而得名。它的功能是在 運算式中 同時完成「指派值給變數」和「傳回該值」兩件事,常用來簡化 while 迴圈中需要先讀取再判斷的重複寫法。
:= 和 = 的差別在於:
=是陳述句(statement),只能單獨使用,不能放在 if/while 的條件式中:=是運算式(expression),可以嵌入在 if/while 等條件式中使用
以下列程式為例,原本要每次都輸入一個值,判斷其值是否為 0,再決定是否繼續下去。
1: a = int(input())
2: while a != 0:
3:     print(f'value: {a}')
4:     a = int(input())
若改為 assignment(:=),則可以寫為
1: # 輸入 0 時結束(0 會被 while 視為 False)
2: while a := int(input()):
3:     print(f'value: {a}')
如此一來,我們就不需要在每次迴圈開始時再重新輸入 a 的值了。這樣的寫法可以讓程式碼更簡潔,並且避免了重複的輸入操作。
海象運算子也可以用在 if 裡面,在判斷的同時把結果存下來。例如我們想計算一個 list 的長度,並在長度超過 3 時印出來:
1: a = [1, 2, 3, 4, 5]
2: # 傳統寫法:先算長度,再判斷
3: n = len(a)
4: if n > 3:
5:     print(f'List 長度為 {n},超過 3')
6:
7: # 海象運算子寫法:算長度和判斷同時完成
8: if (n := len(a)) > 3:
9:     print(f'List 長度為 {n},超過 3')
List 長度為 5,超過 3
List 長度為 5,超過 3
如果要防止轉換錯誤發生:
1: while a := input():
2:     try:
3:         print(f'value: {int(a)}')
4:     except ValueError:
5:         print(f'Not integer')
6:         break;
9. 內建與外部函數
函數是 Python 中一段可以重複使用的程式碼,它可以接受輸入參數並返回結果。Python 提供了許多內建函數,這些函數可以直接使用,而不需要額外的 import。
9.1. 基本函數與運算子
9.1.1. ord()
傳回某字元的 ASCII code /Unicode
1: print(ord('A'))
2: print(ord('©'))
3: print(ord('南'))
4: print(ord('一'))
65
169
21335
19968
9.1.2. chr()
傳回某 ASCII/Unicode 所代表的字元
1: print(chr(97))
2: print(chr(169))
a
©
9.1.3. len()
傳回字串長度
1: print(len('Python基礎'))
8
9.1.4. max()/min()
傳回字串 Unicode 最大/最小字元
1: print(max('Python基礎LALALA'))
2: print(min('Python基礎LALALA'))
3: print(len('Hello'))
礎
A
5
9.1.5. str()
將數值參數轉為字串
1: print(str(3.1416) + str(2020))
3.14162020
9.2. 數值處理函數
- abs(x)
- min(x1, x2 [, x3…])
- max(x1, x2 [, x3…])
- pow(x, y [, z]): docs.python.org
- divmod(x, y)
1: print(max(23, 41, 90))
2: print(min(23, 41, 90))
3: print(pow(2,10))
4: print(divmod(10, 3)) #傳回10/3的商和餘數
90
23
1024
(3, 1)
9.3. 外部函數
有些函數被定義在其他的函式庫中,要使用時必須先 import,例如 sqrt()這個函數就是被定義在 math 函式庫中
1: import math
2:
3: a = 36
4: b = math.sqrt(a)
5: print(b)
6.0
10. 字串
字串(string)是 Python 中表示字元序列的資料結構,字串的應用十分廣泛,例如用來儲存文字資料、表示名稱、地址以及可以表示為文字的其他類型的資料。
10.1. 字串的建立
可以用一對單引號(')、雙引號("")或是三個雙引號來建立字串,例如:
1: str1 = 'This is a string variable'
2: str2 = "這也是字串"
3: str3 = """這還是字串"""
4: print(str1)
5: print(str2)
6: print(str3)
This is a string variable
這也是字串
這還是字串
10.2. 字串資料表示格式
當你建立一個字串變數時,Python 會將它存儲為字元的序列,且每個字元都有一個索引值(index),這使得我們可以透過索引值來存取字串中的特定字元。
1: s = 'TNFSH'
這個變數 s 的實際內容就類似圖15所示
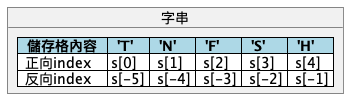
Figure 15: s='TNFSH'的字串內容與索引方式
如同一年級在 C++中看到的陣列一樣,我們可以用如下的語法取得字串中的字元
1: 字串變數[index]: 字串中 index 所在字元
例如
1: sch = 'Tainan First Senior High School'
2: print(sch[0])  # 取得第一個字元
3: print(sch[1])  # 取得第二個字元
與 C/C++的陣列不同的是:在 Python 中,索引值可以是正數或負數。正數從左到右計算,負數則從右到左計算。
1: sch = 'Tainan First Senior High School'
2: print(sch[-1])  # 最後一個字元
3: print(sch[-2])  # 倒數第二個字元
l
o
10.3. 字串資料切片(slice)
字串資料的索引可以使用範圍表示法進行部分切片。語法如下:
1: 字串變數[start:end]: 截取部份字串
上述語法可取得 start <= index < end 的所有子字串。注意這裡是 左閉右開 區間:包含 start 的位置,但 不包含 end 的位置。例如 [1:3] 會取得 index 1 和 index 2 的字元,不會取到 index 3。這個設計和 range() 一樣,都是「含頭不含尾」。例如
1: sch = 'Tainan First Senior High School'
2: print(sch[1:3])
ai
此外,你也可以省略 start 和 end,讓 Python 自動取用整個字串。
1: sch = 'Tainan First Senior High School'
2: print(sch[:3])
3: print(sch[3:])
4: print(sch[:])
Tai
nan First Senior High School
Tainan First Senior High School
10.3.1. 關於 字串[:]
既然start和end都可以省略,那麼,如果兩個一起省略呢?像 =[:] =
我們可以做個實驗:
1: sch = 'Tainan First Senior High School'
2: print(sch[:])
Tainan First Senior High School
欸….這個結果和 sch 本身一樣耶,這是因為 [:] 會取得「從頭到尾」的整個切片,結果當然就是整個字串。
那麼….這和直接 print(sch) 不是一樣嗎?對字串來說,的確完全一樣:字串是不可變的資料(下一節會介紹),Python 沒有必要再複製一份,所以 sch[:] 拿回來的就是 同一個 字串物件,你可以用 print(sch[:] is sch) 驗證,結果會是 True。
那 [:] 有什麼用?它真正派上用場的地方是後面會介紹的 List:List 是可變的資料,=a[:]= 會複製出一份 全新的 List,改新的不會動到舊的。這個差異我們在討論到 List 時會更清楚地看到。現在,我們先來看看切片的另一個應用。
10.3.2. 進階切片
除了start、end,可再加入另一個 increment,每隔數個字元取一個,語法為:
1: 字串變數[start:end:increment]: 截取部份字串
例如
1: sch = 'Tainan First Senior High School'
2: print(sch[1:10:2])
annFr
切片的完整語法是 seq[start:stop:step] ,三個參數都可以省略:
- start 預設為 0(step 為負時預設為 -1,即最後一個元素)
- stop 預設為序列長度(step 為負時預設為序列開頭之前)
- step 預設為 1,可為負數
負數索引代表從尾端算起: seq[-1] 是最後一個元素, seq[-2] 是倒數第二個,依此類推。
常見技巧:
1: s = 'ABCDE'
2: print(s[::-1])   # 反轉字串
3: print(s[-1])     # 最後一個字元
4: print(s[-3:])    # 最後三個字元
5: print(s[::2])    # 每隔一個取一個
EDCBA
E
CDE
ACE
這個切片語法適用於所有序列型別(字串、List、Tuple),用法完全一樣。
10.4. 字串為不可變的資料
在 python 中,字串資料為一種不可變(immutable)的資料類型,這意味著一旦創建了字串,就無法更改它。如果你嘗試直接修改字串中的某個字元,會導致錯誤。
1: sch = 'tainan First Senior High School'
2: sch[0] = 'T'
但可賦予字串變數另一個全新的值,例如
1: sch = 'Tainan First Senior High School'
2: print(sch)
3: sch = 'I Love TNFSH'
4: print(sch)
Tainan First Senior High School
I Love TNFSH
10.5. 範例 2
 1: tel = '06-2371206'
 2: ext = '#600'
 3: # +
 4: print('tel+ext:',tel+ext)
 5: # *
 6: print('ext*2:', ext*2)
 7: # [index]
 8: print('tel[5]:', tel[5])
 9: # [start:end:increment]
10: print('tel[1:4]:',tel[1:4])
11: print('tel[6: ]:',tel[6: ])
12: print('tel[ :6]:',tel[ :6])
13: print('tel[::-1]:',tel[::-1])
14: # in
15: print("'9' in tel:", '9' in tel)
tel+ext: 06-2371206#600
ext*2: #600#600
tel[5]: 7
tel[1:4]: 6-2
tel[6: ]: 1206
tel[ :6]: 06-237
tel[::-1]: 6021732-60
'9' in tel: False
上面最後一個範例用到了 in 這個運算子,它可以拿來判斷某個子字串是否存在於另一個字串中,結果會是 True 或 False。這在日後處理字串時非常好用,例如:
1: email = 'student@tnfsh.tn.edu.tw'
2: if '@' in email:
3:     print('這是一個 email 地址')
4: if 'tnfsh' in email:
5:     print('這是南一中的 email')
這是一個 email 地址
這是南一中的 email
10.6. 相關的字串 function
- len(<str>): 計算字串長度
- <str>.lower(): 字串轉小寫
- <str>.upper(): 字串轉大寫
- <str>.islower(): 字串中英文全小寫
- <str>.isupper(): 字串中英文全大寫
- <str>.find(<str1>): 在<str>尋找<str1>,回傳索引值;
若未找到,回傳-1
- 完整語法:
str.find(sub[, start[, end]]) - start/end 可限制搜尋範圍,例如
s.find('l', 3)會從 index 3 開始找
- 完整語法:
- <str>.replace(<str1>, <str2>): 將<str>中的<str1>以<str2>取代
- 完整語法:
str.replace(old, new[, count]) - count 可限制最多取代幾次,例如
s.replace('a', 'b', 2)在 s 為 'aaa' 時會得到 'bba'
- 完整語法:
- <str>.split([sep]): 字串以 sep 分割, sep 預設值為空白
- 完整語法:
str.split(sep=None, maxsplit-1)= - 不指定 sep 則以任意空白分隔(連續空白視為一個)
- maxsplit 可限制最多切幾刀,例如
s.split(' ', 2)在 s 為 'a b c d' 時得到 ['a', 'b', 'c d']
- 完整語法:
10.7. 範例 3
1: school = 'Tnfsh'
2: print('school:', school)
3: print('len(school):', len(school))
4: print('school.lower():', school.lower())
5: print('school.isupper():', school.isupper())
6: print("school.find('fsh'):", school.find('fsh'))
7: print("school.replace('fsh', 'ssh'):", school.replace('fsh', 'ssh'))
8: print("school.split('f'):", school.split('f'))
school: Tnfsh
len(school): 5
school.lower(): tnfsh
school.isupper(): False
school.find('fsh'): 2
school.replace('fsh', 'ssh'): Tnssh
school.split('f'): ['Tn', 'sh']
10.8. 注意事項
上述的 lower()等 function 貌似改變了字串本身的內容,但實則不然,執行一下底下的程式
1: school = 'TNFSH'
2: print(school)
3: print(school.lower())
4: print(school)
TNFSH
tnfsh
TNFSH
或是
1: text = 'The quick brown fox jumps over the lazy dog'
2: print(text.replace('dog', 'pig'))
3: print(text)
The quick brown fox jumps over the lazy pig
The quick brown fox jumps over the lazy dog
如果你真想直接改變字串本身的內容,可以用底下的方式
1: text = 'The quick brown fox jumps over the lazy dog'
2: text = text.replace('dog', 'pig')
3: print(text)
The quick brown fox jumps over the lazy pig
這種策略適用所有的字串 function,請自己測試。
10.9. 字串與 List
前面提到字串可以用底下的語法來取得子字串
1: text = 'The quick brown fox jumps over the lazy dog'
2: print(text[5:])
3: print(text[:5])
4: print(text[-1])
這個[ ]的用法是不是有點眼熟呢? 還記得在講 split()時,我們提及字串的 split()函數會把分割的子字串分割成如下的結果
1: text = 'The quick brown fox jumps over the lazy dog'
2: print(text.split())
['The', 'quick', 'brown', 'fox', 'jumps', 'over', 'the', 'lazy', 'dog']
我們當時有提及[ ]這個用法代表這是個 List,也就是說,其實我們可以把字串當成一個 List,由一個一個字母所組成的 List,就像以前學 C/C++的陣列,所以可以用 index 來取得陣列中的元素,只是 List 的取用彈性比陣列大的多。
10.9.1. 字串 v.s. List
前面提及 字串 與 字元組成的 List 有點類似,但是還是有幾個地方不同:
1. 元素類型:List 中可以包含不同的資料型態,但字串只能包含字元。
1: scName = ['T', 'N', 'F', 'S', 'H']
2: scList = [93, 44, 79]
2. List 是可變的(可以修改其中的元素),而字串是不可變的。
如下的 scList,我們可以直接變更其中的元素
1: scName = ['T', 'N', 'F', 'S', 'H']
2: scName[2] = 'S'
但如下的字串就不能變更
1: scStr = 'TNFSH'
2: scStr[1] = 'S' #會出錯
你必須用底下的方式生成一個全新的字串內容
1: scStr = 'TNFSH'
2: scStr = 'TNSSH'
3. 型態不同
最後,雖然二者在語法應用上有些許類似的地方,但本質上是不同的變數型態
1: scName = ['T', 'N', 'F', 'S', 'H']
2: scStr = 'TNFSH'
3: print(type(scName))
4: print(type(scStr))
<class 'list'>
<class 'str'>
11. 判斷結構
11.1. if
11.1.1. 語法
- 條件式可不用括號( )含括,條件式後需搭配冒號:
- 程式區塊以縮排方式處理,同一層縮排視為同一程式區塊
- *特別注意*:Python 不像 C/C++ 用大括號
{}來界定程式區塊,而是靠 *縮排*(通常是 4 個空格)。縮排不正確會直接導致程式出錯(IndentationError),這是 Python 初學者最常踩到的坑。
1: if condition:
2:     statement 1
3:     ...
11.1.2. 範例
1: num = 31
2: if num % 2 == 0:
3:     print(f'{num} is even')
4: if num % 2 == 1:
5:     print(f'{num} is odd')
31 is odd
11.1.3. 測試
請先觀察以下程式碼,試著猜測輸出結果後再執行驗證:
1: import math
2: magicNum = 37
3:
4: if math.sqrt(magicNum)*10 < 60:
5:     print('NO', sep='', end='')
6: print('YES', sep='', end='')
YES
想一下:為什麼輸出只有 YES 而不是 NOYES?注意第二個 print() 並不在 if 的縮排區塊內,所以不管 if 的條件是否成立,它都會被執行。而 \(\sqrt{37} \times 10 \approx 60.83\) ,不小於 60,所以 if 區塊中的 print('NO') 不會執行。
11.2. if … else …
11.2.1. 語法
1: if condition:
2:     statement 1
3:     ...
4: else:
5:     statement 3
6:     ...
11.2.2. 範例
1: num = 32
2: if num % 2 == 0:
3:     print(f'{num} is even')
4: else:
5:     print(f'{num} is odd')
32 is even
11.3. if … elif … else …
11.3.1. 語法
 1: if condition 1:
 2:     statement 1
 3:     ...
 4: elif condition 2:
 5:     statement 3
 6:     ...
 7: elif condition 3:
 8:     statement 5
 9:     ...
10: else:
11:     statement N
11.3.2. 範例
 1: score = 87
 2: if score >= 90:
 3:     print('A')
 4: elif score >= 80:
 5:     print('B')
 6: elif score >= 70:
 7:     print('C')
 8: elif score >= 60:
 9:     print('D')
10: else:
11:     print('F')
B
11.3.3. 課堂練習
請撰寫一個程式,根據使用者輸入的年齡來判斷該使用者的票價。票價標準如下:
- 年齡 0 到 5 歲:免費
- 年齡 6 到 12 歲:票價 100 元
- 年齡 13 到 64 歲:票價 200 元
- 年齡 65 歲以上:票價 50 元
- 若輸入年齡不合法(負數),輸出「年齡不合法」。
11.4. 在 C/C++中寫出來會被罵的語法
不同於 C 或 C++,python 允許下列方便的邏輯判斷:
1: score = 87
2: if 60 <= score <= 100:
3:     print("Pass")
4: else:
5:     print("Fail")
Pass
11.5. 巢狀 if
這部份的語法與 C/C++ 中的巢狀 if 相同,Python 也支援巢狀 if 結構。巢狀 if 是指在一個 if 語句內部再包含另一個 if 語句。這樣可以根據多個條件來決定程式的執行路徑。你只要注意 縮排 即可。
11.5.1. 語法
 1: if condition 1:
 2:     statement 1
 3:     ...
 4:     if condition 2:
 5:         statement 3
 6:         ...
 7:     else:
 8:         statement 5
 9:         ...
10: else:
11:     if condition 3:
12:         statement 7
13:         ...
14:     else:
15:         statement N
16:         ...
11.5.2. 範例: 某年份是否為閏年
解題流程
閏年判斷流程
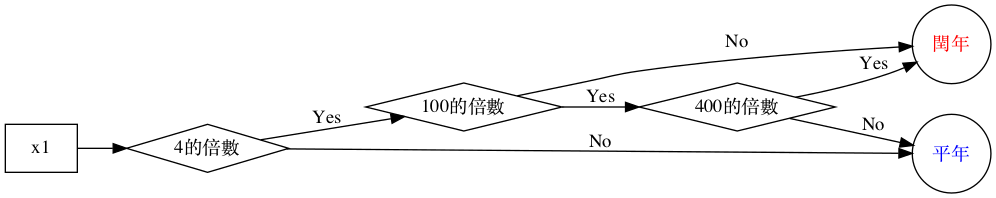
Figure 16: 閏年判斷流程
code #1
year = int(input("請輸入一個年份:"))
if (year % 4) == 0:
    if (year % 100) == 0:
        if (year % 400) == 0:
            print(f"{year}年是世紀閏年")
        else:
            print(f"{year}年為平年")
    else:
        print(f"{year}年是普通閏年")
else:
    print(f"{year}年為平年")
code #2
year = int(input("請輸入一個年份:"))
if (year % 4) == 0 and (year % 100) !=0 or (year % 400) == 0:
    print(f"{year}年是閏年")
else:
    print(f"{year}年為平年")
11.6. match-case (Python 3.10)
類似 C/C++的 switch-case 結構,從 3.10 版開始支援,使用前請先確定 python 版本。
當你有很多個值要逐一比對時,用 if-elif-else 可以做到,但寫起來會比較冗長。match-case 提供了更簡潔的寫法:
match後面放要比對的變數- 每個
case後面放一個要比對的值(或用|連接多個值) case _是萬用匹配,類似 C/C++ 的 default,表示「以上都不符合時」
 1: #name = input("What's your name? ")
 2: name = "Harry"
 3:
 4: match name:
 5:     case "Harry" | "Hermione" | "Ron":
 6:         print("Gryffindor")
 7:     case "Draco":
 8:         print("Slytherin")
 9:     case _:
10:         print("Who?")
11.7. 如何確認 python 版本
11.7.1. Python script
- System module
1: import sys
2: print(sys.version)
3.13.11 (main, Dec  5 2025, 16:06:33)
[Clang 17.0.0 (clang-1700.4.4.1)]
- platform module
1: import platform
2: print(platform.python_version())
3.13.11
11.7.2. Terminal
1: python --version
Python 3.13.11
12. 迴圈結構
和 C/C++一樣,Python 也有迴圈結構,主要有兩種:while 迴圈和 for 迴圈。while 迴圈會在條件為真時持續執行,而 for 迴圈則是用來遍歷序列(如列表、字串等)。
12.1. for
Python 的 for 迴圈非常好用,除了可以像 C/C++那樣遍歷數字序列,還可以遍歷字串、列表、元組、字典等資料結構。這使得 Python 的 for 迴圈在處理資料時非常靈活和方便。
12.1.1. 語法
1: for variable in sequence:
2:     statement 1
3:     ...
- for 迴圈的變數會依序走訪 sequence 中的元素
- 這裡的 sequence 可以放 字串(string)、range 函式、表列(list)、元組(tuple)、字典(dict)、集合(set)
12.1.2. Sequence 為 String
在之前的章節中,我們提及了字串(string)是由一個一個字元所組成的,所以,字串本質上也是一種序列(sequence),可以使用 for 迴圈來遍歷字串中的每個字元。這使得 Python 的字串處理非常方便。
1: school = 'TNFSH'
2: for x in school:
3:     print(x, end=' ')
4: print('\n=========')
5: for x in school:
6:     print(chr(ord(x)+1), end=' ')
T N F S H
=========
U O G T I
- ord( ) -> 將字元轉為 Unicode 編碼(整數);英文字母與數字的部分和 ASCII 相同,中文字也可以
- chr( ) -> 將 ASCII 編碼(整數)轉為字元
1: school = '高雄市'
2: for x in school:
3:     print(x, end=' ')
4: print('\n=========')
5: for x in school:
6:     print(chr(ord(x)+1), end=' ')
7:
高 雄 市
=========
髙 雅 布
12.1.3. Sequence(序列) 為 range() function 語法
但是,如果我們需要像在 C++那樣生成一個整數序列來控制迴圈呢?例如:
1: #include <iostream>
2: using namespace std;
3: for(int i=0; i<10; i++){
4:     cout << i << " ";
5: }
在 Python 裡,我們可使用 range() 函式,這個函式會 產生 一個 整數 序列,通常用於迴圈中。
語法
for variable in range([起始值,] 終止值 [,遞增值]):
    statement 1
    ...
- 起始值預設為 0,遞增值預設為 1
- 起始值 ≤ range( )的範圍 < 終止值
range() 其實有三種呼叫方式:
| 寫法 | 說明 |
|---|---|
range(stop) |
從 0 到 stop-1 |
range(start, stop) |
從 start 到 stop-1 |
range(start, stop, step) |
從 start 開始,每次加 step,不含 stop |
step 可以是負數,用來產生遞減序列,例如 range(10, 0, -1) 會產生 [10, 9, 8, …, 1]。注意:step 為負時,start 必須大於 stop,否則會得到空序列。
想知道 range() 產生的序列內容,可以使用 list() 函式將其轉換為列表來查看
1: print(range(4))
2: print(list(range(4)))
range(0, 4)
[0, 1, 2, 3]
range()傳回的是一個 range 物件,所以要用 list()
範例
1: for x in range(4):
2:     print(x)
3: print('========')
4: for x in range(3, 10):
5:     print(x, end=', ')
6: print('\n========')
7: for x in range(3, 10, 2):
8:     print(x, end=',')
0
1
2
3
========
3, 4, 5, 6, 7, 8, 9,
========
3,5,7,9,
用負數 step 來倒數:
1: print(list(range(5, 0, -1)))    # 從 5 倒數到 1
2: print(list(range(10, 0, -2)))   # 從 10 開始,每次減 2
[5, 4, 3, 2, 1]
[10, 8, 6, 4, 2]
重要觀念
- 請問下列程式會輸出幾個*
1: for i in range(10):
2:     print('*')
答案是 10 個 。因為
range(10)已經預先產生了 [0,1,2,…,9] 這個序列,每次迴圈開始時 Python 會從序列中取出下一個值指派給 i,所以即使你在迴圈裡把 i 改成 5,下一輪 i 還是會被序列中的下一個值覆蓋。
- 如果把程式改成這樣,會輸出什麼?
1: for i in range(10):
2:     i = 5
3:     print(i)
答案是輸出 10 次 5。
- 這和你所熟悉的 C/C++有什麼不一樣呢?
在 C/C++ 中,如果你在 for 迴圈裡改變了迴圈變數 i 的值(例如
for(int i=0; i<10; i++)中把 i 改成 5),那下一輪就會從 i=6 開始判斷,可能會影響迴圈的執行次數。
但在 Python 中,=for i in range(10)= 的運作方式不同:range(10) 會預先產生一個序列 [0, 1, 2, …, 9],每一輪迴圈開始時,Python 會從這個序列中依序取出下一個值重新指派給 i。所以即使你在迴圈中把 i 改成 5,到了下一輪 i 還是會被序列中的下一個值覆蓋,迴圈照樣跑滿 10 次。
12.1.4. 把 range()用在字串上
雖然上面提到以 for 迴圈直接走訪字串的每個字元,但有時我們也會需要用 index 來走訪字串,這時就可以把 range() 與 len() 函式搭配使用。
1: school = 'TNFSH'
2: for i in range(len(school)):
3:     print(school[i], end=' ')
12.1.5. 課堂練習
以 FOR 輸出以下字串(提示:字串有兩個常用 function: ord()/chr())
abcdefghijklmnopqrstuvwxyz
zyxwvutsrqponmlkjihgfedcba
12.1.6. Sequence 為 List
和字串十分類似,Python 的列表(List)也是一種序列,因此可以使用 for 迴圈來遍歷列表中的每個元素。這使得 Python 的列表處理非常方便。
1: nums = [60, 70, 30, 110, 90]
2: for i in nums:
3:     print(i)
12.1.7. 如何將 一整列以空白為間隔的數字 全部轉成整數再讀進 List 中
想像一下我們要讀入並處理底下這一行的 5 個數字(也許是把它們加總起來):
55 34 12 93 78
以前使用 C/C++時,我們可以直接用 cin >> 來讀入每個數字,然後再將它們加總起來。
1: #include <iostream>
2: using namespace std;
3: int main() {
4:     int a, b, c, d, e;
5:     cin >> a >> b >> c >> d >> e;
6:     cout << a + b + c + d + e << endl;
7:     return 0;
8: }
但是在 Python 中,如果我們使用 input() 函式來讀取資料,結果就是這一行資料都會被一口氣讀進來,我們得到就一串以空白間隔的字串:
1: numStr = input()
2: print(numStr)
結果會是這樣:
55 34 12 93 78
如何把這個字串裡的數字分割開來,並轉換成整數呢?
- 我們可以先利用 split() 方法將字串分割成一個列表,這樣每個數字就會成為列表中的一個元素。
- 接著,我們可以使用 map() 函式將列表中的每個元素轉換為整數。
- map()函式傳回的是一個迭代器,因此我們可以使用 list() 函式將其轉換為列表。
以下是上述步驟的實作:
1: numList = list(map(int, input().split()))
2: tot = 0
3: for i in numList:
4:     tot += i
5: print(tot)
272
12.2. break / else / continue / pass
break 顧名思義就是「中斷」的意思,當你在迴圈中使用 break 時,迴圈會立即終止,並跳出迴圈。else 則是用來處理迴圈正常結束後的情況。
12.2.1. break
在迴圈中,只要碰到 break 就會跳出迴圈,無論是 while 或 for 迴圈都會馬上跳出。使用 break 陳述句,你只需要打上 break,不須加其他東西。
例
1: for i in range(10):
2:     print(i)
3:     if i == 5:
4:         break
5: print('END')
0
1
2
3
4
5
END
看起來好像沒什麼用對吧?如果只是希望迴圈跑到某個數字就結束,這樣的寫法確實有點多餘,但如果我們想要在迴圈中找到某個特定的條件時就結束迴圈,那麼 break 就非常有用了。
適用時機
檢查某一數是否為質數(假設 n=15)時,常見的做法是由 2~7 逐一測試是否能整除 n,然而測到 3 時就會發現 n 可以被 3 整除,此時還需要再往下測嗎?當然不用,這就是 break 最佳出場時機了…
1: num = 32
2: for i in range(2, num//2 + 1):
3:     if num % i == 0: #找到因數
4:         print('這不是質數')
5:         # 既然已經確定不是質數,就不用再去找其他因數了,可以結束這個for迴圈
6:         break
這不是質數
有沒有覺得上面的要求有點 déjà vu?
高一時我們曾經練習過利用 C++寫出判斷某數是否為質數的程式,上面的例子就可以用來解決其中的一個部份功能:如果找到因數,那麼這個數就不是質數….
練習
給定一個正整數 N,請寫一個 Python 程式判斷它是否為質數。
- 質數的定義:大於 1 的自然數,除了 1 和自己之外沒有其他因數。最前面幾個質數為 {2, 3, 5, 7, 11, …}。
- 範例:
Input:  11
Output: true
Input:  15
Output: false
Input:  1
Output: false
12.2.2. else
這是 Python 的一個獨特語法,在 C/C++ 裡是不存在的:你可以在 for 迴圈後面接一個 else。
直覺上你可能會覺得「迴圈為什麼要配 else?」,其實這裡的 else 可以理解為「如果迴圈 *沒有被 break 中斷*,就執行 else 裡的程式碼」。換個角度想:
- 迴圈跑到尾巴自然結束(正常結束)→ 執行 else
- 迴圈中途被 break 打斷(不正常結束)→ 不執行 else
範例
回到上面的例子,那如果找一直找不到因數呢?顯然 for 迴圈就會從頭跑到尾,都沒機會去執行 break,換句話說,就是迴圈 正常結束 ,這代表:這個數就是質數,這就是 else 出場的時候了….
1: num = 37
2: for i in range(2, num//2 + 1):
3:     if num % i == 0:
4:         print('這不是質數')
5:         # 既然已經確定不是質數,就不用再去找其他因數了,可以結束這個for迴圈
6:         break
7: else:
8:     # 如果上面的for迴圈都沒被break,表示if一直不成立,表示都找不到一個因數
9:     print('這是質數')
這是質數
有沒有覺得這個設計很好用?沒有的話再把這段從頭看一次……
12.2.3. continue
跳出單次 loop、繼續下一個迴圈。和 break 不同,continue 只會跳過其中的一次迴圈,但是仍會繼續往下把整個迴圈跑完。
範例
1: count = 0
2: for letter in 'Python':
3:     count += 1
4:     if letter == 'h':
5:         continue
6:     print('Processing Letter:', letter)
7: print(f'迴圈一共跑了{count}次')
Processing Letter: P
Processing Letter: y
Processing Letter: t
Processing Letter: o
Processing Letter: n
迴圈一共跑了6次
練習
給定一個字串,印出該字串中除了 'N' 和 'S' 以外的所有字母。
- 範例:
Input: TNFSH
Output: TFH
12.2.4. pass
什麼事都不幹…..
- pass 是 Python 中的一個空語句,當你需要一個語句但又不想執行任何操作時,可以使用 pass。它通常用於佔位符,表示這裡將來會有程式碼,但目前還沒有實作。
範例
1: count = 0
2: for letter in 'Python':
3:     count += 1
4:     if letter == 'h':
5:         pass
6:     print('Processing Letter:', letter)
7: print(f'迴圈一共跑了{count}次')
Processing Letter: P
Processing Letter: y
Processing Letter: t
Processing Letter: h
Processing Letter: o
Processing Letter: n
迴圈一共跑了6次
啊有差嗎?
在迴圈中使用 pass 語句,執行程式後,你會發現什麼事也沒做,完全不起任何作用,只是一個空運算而已,那問題就來了:
如果什麼事都不做,就不用寫啦,那 pass 語句是要做什麼的? …… ✍︎
其實有時候會有非寫不可的情況!!
pass 就像是 To do 的概念,在寫程式的時候,有時候想的比實際寫出來的速度快,例如定義一個函數,但還沒有實作出來,空著內容不寫又會產生語法錯誤,這時就會使用 pass 來替代,當作是個指標,提醒自己之後要來完成7。
1: def myfunction():
2:     pass  #提醒自己之後要來完成
或是,如果你要自訂一個 Exception class
1: class MyException(Exception):
2:     pass
3:
4: try:
5:     1/0
6: except:
7:     pass
沒有 pass 的話上述程式碼就會出錯
又或者看一下底下的例子8:
1: text = "I am a coder."
2:
3: if text == "I am not a coder.":
4:     print("Programming is interesting! You should try it out!")
5: elif text == "I am a coder.":
6:     pass
- 簡單來說,~pass~ 就是一個「什麼都不做」的佔位符。Python 的語法規定 if、迴圈、函式裡面不能完全留空,所以當你暫時不想寫任何東西時,就用
pass來佔位。 pass常用在還沒實作完成的函式、類別或迴圈中,作為未來補上程式碼的提醒。
12.3. while
12.3.1. 語法與使用時機
基本用法與 C/C++相同:
1: while condition:
2:     statement 1
3:     ...
只要 condition 成立,就一直重複執行縮排的區塊;condition 不成立時結束迴圈。
那什麼時候用 for、什麼時候用 while?一個簡單的判斷方式:
- 知道要跑幾次 (例如走訪一個 List、從 1 數到 100):用 for
- 不知道要跑幾次,只知道什麼時候該停 (例如使用者輸入正確密碼為止、讀到沒資料為止):用 while
12.3.2. 計數型 while
先從最簡單的開始:印出 1 到 5。用 for 一行 range 就解決了,用 while 的話,計數這件事要自己來:
1: i = 1            # 1. 設定起始值
2: while i <= 5:    # 2. 設定結束條件
3:     print(i)
4:     i += 1       # 3. 每一圈更新計數變數
1
2
3
4
5
這三件事缺一不可。特別是第 3 步,如果忘了寫 i += 1 ,i 永遠是 1、條件永遠成立,程式就會 無限迴圈 停不下來(這時可以按 Ctrl-C 強制中斷)。這是初學 while 最常犯的錯,之後每寫一個 while 都先問自己:「迴圈裡有沒有讓條件最終會變成 False 的那一行?」
12.3.3. 條件型 while:讀到符合條件為止
while 真正的強項是「不知道要跑幾次」的狀況,最典型的就是讀取使用者輸入。例如登入系統:使用者輸對密碼之前,就一直要他重新輸入:
1: password = 'tnfsh403'
2: guess = input('Enter password ')
3: while guess != password:
4:     guess = input('Try again ')
5: print('Welcome to MacLab 403...')
注意這個結構:進迴圈 之前 先讀一次,迴圈裡面讀錯了就 再讀一次 ,這樣 while 的條件才有東西可以判斷。
同樣的結構也可以用來連續讀入資料:老師要輸入全班成績算總分,但不知道有幾個人。約定輸入 -1 代表「沒有了」(成績不可能是負的,所以 -1 不會和真實資料混淆):
1: total = 0
2: score = int(input('請輸入成績(-1 結束):'))
3: while score != -1:
4:     total += score
5:     score = int(input('請輸入成績(-1 結束):'))
6: print(f'總分:{total}')
執行結果:
請輸入成績(-1 結束):80
請輸入成績(-1 結束):95
請輸入成績(-1 結束):70
請輸入成績(-1 結束):-1
總分:245
12.3.4. while True + break:先做再判斷
上面兩個例子都要在迴圈前後各寫一次 input(),有點囉嗦。另一種寫法是讓條件永遠成立(=while True=),然後在迴圈 裡面 用 break 決定什麼時候跳出:
1: total = 0
2: while True:
3:     score = int(input('請輸入成績(-1 結束):'))
4:     if score == -1:
5:         break
6:     total += score
7: print(f'總分:{total}')
break 會立刻跳出迴圈,規則和前面 for 迴圈學到的一樣。這種寫法是「先做再判斷」,和前一節「先判斷再做」剛好相反,input() 只要寫一次。在需要持續讀取使用者輸入的程式裡很常見:
1: while True:
2:     print('How is your day?')
3:     your_reply = input()
4:     if your_reply == 'quit':
5:         break
6: print('good bye')
12.3.5. while … else
while 迴圈也支援 else,規則和 for 一樣:else 只在迴圈「沒有被 break 中斷」、自然結束時才會執行。
把前面的密碼檢查升級一下:最多只能猜三次。猜對就 break 跳出;如果三次都猜錯,迴圈是因為 tries < 3 不成立而自然結束的,這時就由 else 來處理鎖定帳號的工作:
 1: password = 'tnfsh403'
 2: tries = 0
 3: while tries < 3:
 4:     guess = input('請輸入密碼:')
 5:     if guess == password:
 6:         print('登入成功')
 7:         break
 8:     tries += 1
 9:     print(f'密碼錯誤,還有 {3 - tries} 次機會')
10: else:
11:     print('錯誤次數過多,帳號已鎖定')
執行結果(連續輸錯三次):
請輸入密碼:1234
密碼錯誤,還有 2 次機會
請輸入密碼:abcd
密碼錯誤,還有 1 次機會
請輸入密碼:0000
密碼錯誤,還有 0 次機會
錯誤次數過多,帳號已鎖定
12.3.6. 練習: 用 else 取代 flag
判斷一個數 n 是質數還是合數:從 2 開始一路試除到 n-1,只要有任何一個數整除 n,n 就是合數;全部試完都沒有人整除,n 才是質數。這正是「迴圈是不是從頭到尾都沒找到」的問題。
在還沒有 else 可用之前,通常要自己準備一個旗標變數(flag),找到因數就把它翻成 True,迴圈結束後再檢查它。用 while 迴圈時,除了要維護 flag,還要自己控制除數 i 的遞增,程式就更囉嗦了:
code 1: 用 flag
 1: n = 91
 2: found = False
 3: i = 2
 4: while i < n:
 5:     if n % i == 0:
 6:         found = True
 7:         print(f'{n} 是合數,可被 {i} 整除')
 8:         break
 9:     i += 1
10:
11: if not found:
12:     print(f'{n} 是質數')
有了 while…else 之後,flag 就可以拿掉了:「沒有被 break 中斷」這件事由 else 來判斷,程式少了一個變數,也少了一次判斷:
code 2: 用 else
1: n = 91
2: i = 2
3: while i < n:
4:     if n % i == 0:
5:         print(f'{n} 是合數,可被 {i} 整除')
6:         break
7:     i += 1
8: else:
9:     print(f'{n} 是質數')
請試著把 n 改成 97,分別執行兩段程式,確認兩者的輸出相同。
12.3.7. 進階範例: 最大公因數(輾轉相除法)
把 (m, n) 換成 (n, m 除以 n 的餘數),直到餘數為 0,此時 m 就是最大公因數:
1: m, n = 42, 75
2: while n > 0:
3:     m, n = n, m % n
4: print(m)
3
12.4. while與多測資輸入
大多數的輸入要求都會很善良的告訴你接下來有幾個數值要輸入,例如教學網作業5C: You shell not pass!!
- 甘道夫在《魔戒》裡的一句「You Shall not PASS!」已經變成這個世代拿來嘲諷改造的一句名言,然而對於正在高中受難的你,仍然很害怕這句詛咒…..,每個學期總要接受來自各個老師的挑戰………
- 輸入:讀入一個整數 n,接下來要讀入 n 個數字,代表你這學期的 n 科成績。
- 輸出:若你這學期的所有科目均為 60 以上,則輸出"HAHA, I PASS!!! Bite me!!!",若至少有一科不及格,則輸出"Oh, No!!!",所有輸出最後均要跳行。
接下來會有這麼一段輸入:
1: 3
2: 60
3: 80
4: 12
於是我們就可以很舒服愉快的用以下的程式碼來讀完所有的資料:
1: n = int(input())
2: for i in range(n):
3:     score = input()
但是,可惜有些時候我們並無法確定到底一共會有多少筆資料要讀取(因為出題的人不想告訴你-_-),所以任務就變成 一直讀入資料,讀到沒東西讀 。以前在 C++面對這種待讀資料筆數不確定的狀況時可以用 while 來處理:
1: int n;
2: while (cin>>n) {
3:     //....
4: }
意思非常直白,就是讀到沒東西讀為止, cin 讀不到東西後就會傳回 false,結束 while()。
在 Python 中,我們可以利用 try…except 來處理這個問題。在此之前,先認識一下 EOF(End of File,檔案結尾)這個概念:如圖17,任何檔案都有結尾,程式一筆一筆往下讀,讀完最後一筆之後再讀一次,作業系統就會告訴程式「沒有了,到此為止」,這個「已經讀到檔案結尾」的訊號就叫 EOF。要注意的是,EOF 並 不是 真的存在檔案裡的某個符號,用文字編輯器打開檔案是看不到它的,圖中最後一行的 EOF 只是用來標示「資料到這裡結束」的示意。
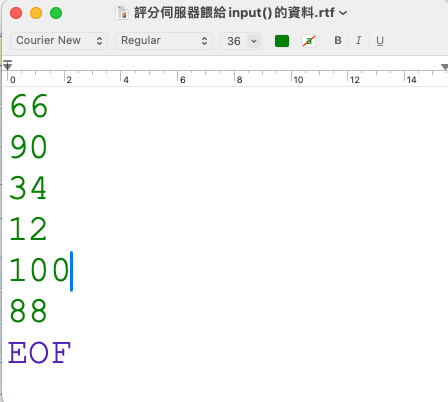
Figure 17: 檔案中的 EOF
那,這和我們用 input() 讀資料有什麼關係呢?當我們把一隻像這樣的程式送到評分伺服器(online judge server)時:
1: for i in range(3):
2:     n = int(input())
評分系統並不是有人坐在那裡幫你打鍵盤輸入測資,而是事先把要「餵」給程式的測試資料存成一個 檔案 ,再把這個檔案接到程式的輸入端。所以你的程式每一次呼叫 input(),其實都是從這個檔案讀一列。以前題目都會先告訴你一共有幾筆資料,用 for 讀固定次數就好,永遠不會讀到檔案結尾;現在如果題目不說有幾筆,要你「讀到沒東西讀為止」,那我們就得學會怎麼判斷 EOF 了。整個流程如圖18:
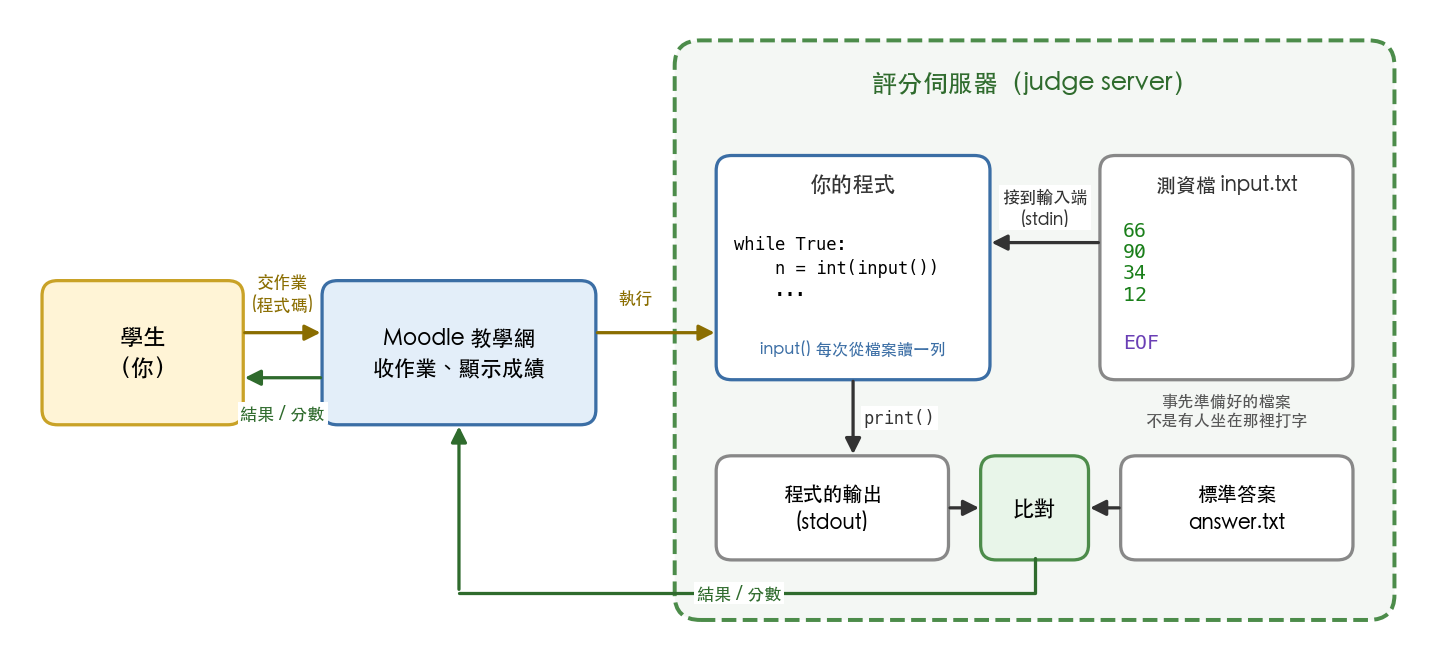
Figure 18: 程式、測資、Moodle 與評分伺服器的關係
接下來會介紹兩種做法。 特別注意 :教學網(Moodle)的評分系統準備的測資檔,結尾會多一個空列,所以只攔 EOFError 的做法 1 在教學網上 會出錯 ,交作業時一定要用做法 2 的寫法。做法 1 仍然要看懂,因為它是最基本的原理,也是其他評分系統(例如 SkyOJ)常用的寫法。
12.4.1. 做法 1: 攔截 EOFError
當 input() 讀到檔案結尾時,它 根本不會傳回任何東西 ,而是直接丟出一個 EOFError 例外(注意:錯誤是 input() 發出的,還沒輪到 int() 出手)。所以我們可以用 try…except 把這個例外抓下來,當成「資料讀完了」的訊號來結束迴圈:
1: t = []
2: while True:
3:     try:
4:         n = int(input())  # 讀取輸入並轉換為整數
5:         t.append(n)
6:     except EOFError:      # input() 讀到檔案結尾
7:         break             # 結束迴圈
8:
9: print(t) #檢查一下讀到的資料
- EOF 是從檔案讀取資料時讀到檔案結尾的訊號,但是一般我們在寫程式都是從鍵盤輸入資料來進行測試,那怎麼送出一個 EOF 給程式呢?答案是在新的一列按 Ctrl-D(MacOS、Linux) 或 Ctrl-Z 再按 Enter(Windows)。
12.4.2. 做法 2: 同時攔截 EOFError 與 ValueError
有些評分系統(moodle教學網就是其中之一)準備的測資檔最後會多一個空列,這時 input() 不會丟出 EOFError,而是傳回空字串 '' ,接著 int('') 就會丟出 ValueError 。如果只寫 except EOFError: ,程式就會在這裡當掉。比較保險的寫法是兩種例外一起攔:
1: t = []
2: while True:
3:     try:
4:         n = int(input())
5:         t.append(n)
6:     except (EOFError, ValueError):  # 讀到檔案結尾,或讀到空列
7:         break
8:
9: print(t)
- 如果你讀進來的是字串、沒有經過 int() 轉換,那麼多出來的那個空列就會以
''的型式混進 list 裡,記得在讀入後先 print 出來檢查,必要時用if s ='': break= 把它擋掉。
12.4.3. except EOFError: 和 except: 都可以嗎?
都能讓迴圈停下來,但不是等價的,差別在「攔到什麼」:
except EOFError:只攔「資料真的讀完」這一種情況。遇到測資檔尾端多一個空列的評分系統,input() 會先傳回'',=int('')= 丟出的是 ValueError 而不是 EOFError,程式就會在那裡當掉。except:什麼例外都攔,EOFError 和 ValueError 都會被當成「讀完了」,所以看起來「能跑」。但它也會攔到你自己的 bug:變數名打錯的 NameError、型別用錯的 TypeError,甚至按 Ctrl-C 的 KeyboardInterrupt。程式會安靜地跳出迴圈、印出不完整的結果,你完全不知道中間出了錯,debug 時會很痛苦。- 所以正確的寫法是做法 2:把要攔的例外 點名 寫出來,=except (EOFError, ValueError):= 。既能應付真正的 EOF,也能應付尾端空列,而其他錯誤仍會正常報出來。
- 一句話記住:
except:能跑,但它等於把所有警報器都拆掉;點名要攔的例外才是正確習慣。
12.5. 巢狀迴圈
12.5.1. 範例
1: for i in range(1, 10):
2:     for j in range(1, 10):
3:         print(f'{i}*{j}={i*j:2d}', end=' ')
4:     print()
5:
1*1= 1 1*2= 2 1*3= 3 1*4= 4 1*5= 5 1*6= 6 1*7= 7 1*8= 8 1*9= 9
2*1= 2 2*2= 4 2*3= 6 2*4= 8 2*5=10 2*6=12 2*7=14 2*8=16 2*9=18
3*1= 3 3*2= 6 3*3= 9 3*4=12 3*5=15 3*6=18 3*7=21 3*8=24 3*9=27
4*1= 4 4*2= 8 4*3=12 4*4=16 4*5=20 4*6=24 4*7=28 4*8=32 4*9=36
5*1= 5 5*2=10 5*3=15 5*4=20 5*5=25 5*6=30 5*7=35 5*8=40 5*9=45
6*1= 6 6*2=12 6*3=18 6*4=24 6*5=30 6*6=36 6*7=42 6*8=48 6*9=54
7*1= 7 7*2=14 7*3=21 7*4=28 7*5=35 7*6=42 7*7=49 7*8=56 7*9=63
8*1= 8 8*2=16 8*3=24 8*4=32 8*5=40 8*6=48 8*7=56 8*8=64 8*9=72
9*1= 9 9*2=18 9*3=27 9*4=36 9*5=45 9*6=54 9*7=63 9*8=72 9*9=81
12.5.2. 如何將資料讀入二維陣列
1: a = [1, 2, 3, 4]
2: b = [5, 6, 7, 8]
3: c = []
4: c.append(a)
5: c.append(b)
6: print(c)
[[1, 2, 3, 4], [5, 6, 7, 8]]
12.6. 實作練習
12.6.1. 所有位數平方和
輸入一個整數,輸出該整數所有位數平方和
Example
Input: 12345
Output: 55
12.6.2. 從 1 加到多少才不會超過 m?
- 求 1+2+3+…+n<=m,已知 m 時之最大的 n 值。
- 輸入 m,輸出 n。
12.6.3. 輸出 99 乘法表
輸出如下的結果
1*1= 1   1*2= 2   1*3= 3   1*4= 4   1*5= 5   1*6= 6   1*7= 7   1*8= 8   1*9= 9
2*1= 2   2*2= 4   2*3= 6   2*4= 8   2*5=10   2*6=12   2*7=14   2*8=16   2*9=18
3*1= 3   3*2= 6   3*3= 9   3*4=12   3*5=15   3*6=18   3*7=21   3*8=24   3*9=27
4*1= 4   4*2= 8   4*3=12   4*4=16   4*5=20   4*6=24   4*7=28   4*8=32   4*9=36
5*1= 5   5*2=10   5*3=15   5*4=20   5*5=25   5*6=30   5*7=35   5*8=40   5*9=45
6*1= 6   6*2=12   6*3=18   6*4=24   6*5=30   6*6=36   6*7=42   6*8=48   6*9=54
7*1= 7   7*2=14   7*3=21   7*4=28   7*5=35   7*6=42   7*7=49   7*8=56   7*9=63
8*1= 8   8*2=16   8*3=24   8*4=32   8*5=40   8*6=48   8*7=56   8*8=64   8*9=72
9*1= 9   9*2=18   9*3=27   9*4=36   9*5=45   9*6=54   9*7=63   9*8=72   9*9=81
12.7. 作業
12.7.1. 因數和
- 輸入 n,輸出 n 除了 1 和自己以外的所有因數和
- 若該數為質數(沒有這樣的因數),則輸出 XD
12.7.2. 所有位數和
輸入一整數,輸出該整數的所有位數和
12.7.3. 級數求和
- 已知: \(S_n = 1 + \frac{1}{2}+\frac{1}{3}+\dots+\frac{1}{n}\) 。顯然對於任意一個整數 K,當 n 足夠大時,S_n 就會大於 K。
現在給出一個整數 K(\(1 \leq K \leq 15\)),求一個最小的 n,使\(S_n>K\) 。 - 輸入: K
- 輸出: n
12.7.4. 保安~~可以讓人這樣一乘再乘嗎?
- 輸入: 讀入一整數 n、接下來讀入 n 個整數,最後輸入一個整數 m。
- 輸出:將所有 n 個數相乘、再將所得乘積除以 m、輸出餘數
- 提示:( a * b) % c = ( ( a % c ) * ( b % c ) ) % c
12.7.5. To pass or not to pass; that is a question.[APCS]
- 一次考試中,於所有及格學生中獲取最低分數者最為幸運,反之,於所有不及格同學中,獲取最高分數者,可以說是最為不幸,而此二種分數,可以視為成績指標。
請你設計一支程式,讀入全班成績(人數不固定),請對所有分數進行排序,並分別找出不及格中最高分數,以及及格中最低分數。
當找不到最低及格分數,表示對於本次考試而言,這是一個不幸之班級,此時請你印出:「worst case」;反之,當找不到最高不及格分數時,請你印出「best case」。
註:假設及格分數為 60,每筆測資皆為 0~100 間整數,且筆數未定。 - 輸入:第一行為各學生分數(0~100 間),分數與分數之間以一個空白間格。每一筆測資的學生人數為 1~20 的整數。
- 輸出:每筆測資輸出三行。
第一行由大而小印出所有成績,兩數字之間以一個空白間格,最後一個數字後無空白;
第二行印出最高不及格分數,如果全數及格時,於此行印出 best case;
第三行印出最低及格分數,當全數不及格時,於此行印出 worst case。
12.7.6. Binary code[APCS]
任何文字與數字在電腦中儲存時都是使用二元編碼,而所謂二元編碼也就是一段由 0 與 1 構成的序列。在本題中,A~F 這六個字元由一種特殊方式來編碼,在這種編碼方式中,這六個字元的編碼都是一個長度為 4 的二元序列,對照表如下:
字元 A B C D E F 編碼 0101 0111 0010 1101 1000 1100 - 輸入:第一行是一個正整數 N,1 ≤ N ≤ 4,以下有 N 行,每行有 4 個 0 或 1 的數字,數字間彼此以空白隔開,每一行必定是上述六個字元其中之一的編碼。
- 輸出:輸出編碼所代表的 N 個字元,字元之間不需要空白或換行間格。
12.7.7. 奇奇復奇奇[APCS]
- 將一個十進位正整數的奇數位數的和稱為 A,偶數位數的和稱為 B,則 A 與 B 的絕對差值|A-B|稱為這個正整數的奇偶差。
例如:263541 的奇數位數的和 A = 6+5+1 = 12,偶數位數的和 B = 2+3+4 = 9,所以 263541 的奇偶差是|12-9|= 3。
給定一個十進位正整數 X,請找出 X 的奇偶差。 - 輸入:輸入為一行含有一個十進位表示法的正整數 X,之後是一個換行字元。
- 輸出:請輸出 X 的奇偶差 Y(以十進位表示法輸出),以換行字元結尾。
12.7.8. Super Mario[簡化版]
- 應俱備能力
- for
- if
- for
- 瑪莉歐(Mario)在最後的城堡。他現在需要跳過一些牆壁,然後進入庫巴(Koopa)的房間,他要打敗怪物,以拯救公主。
對於這個問題,我們只關注“翻過牆”的一部分。
你將被給予 N 個牆壁(由左至右)的高度。
瑪莉歐(Mario)目前站在第一個牆壁。他必須跳到相鄰的牆壁直到最後一個。
這意味著,他將跳躍 N - 1 次。a high jump 代表瑪莉歐(Mario)跳到一個較高的牆,同樣,a low jump 代表瑪莉歐(Mario)跳到一個較矮的牆。
你能找出 a high jump 和 a low jump 的總數嗎? - 輸入:測資有兩列,第一列為一個正整數 N(N < 50),表示牆壁的數目。下一行依序為 N 個牆壁的高度(由左至右)。每一個高度是不超過 10 的非負整數。
- 輸出:兩列,每列一個數字,第一列數字代表 high jumps 總數;第二列數字代表 low jumps 的總數。
12.7.9. 打疫苗囉
說明
- BNT 開打了, 一堆學生跑去排隊,只是,到了現場排好隊後,有一堆學生現場暈針,臉上三條線的護士只好把這些暈針的學生拉到隊伍的最後面….
- 已知學生排隊的狀況如下,其中數字代表學號,0為暈針的學生
98122 98114 98001 98008 0 98013 0 98028 - 請在不影響其他學生排隊順序的前提下,把暈針的學生全部排到隊伍的最後面,上例的結果如下
98122 98114 98001 98008 98013 98028 0 0
輸入
以空白間隔的學號,已知學生人數不超過 10 萬人
輸出
每個學生的學號都以一個英文空白間隔,最後一個學號後面沒有空白
13. 資料型別-LIST, TUPLE
13.1. 為什麼需要資料型別
接下來介紹的幾種 Python 的資料型別,主要是為了讓程式能夠更有效率地處理不同種類的資料,尤其是如何有效的儲存與運算大量的資料。
為什麼需要一個能儲存大量資料的型別呢?
如果要計算 5 個學生的平均成績,當然可以用 5 個變數來儲存 5 個成績,再計算平均值,例如:
1: a, b, c, d, e = map(int, input().split()) #輸入5個成績,以空白分隔
2: avg = (a + b + c + d + e) / 5
3: print(f'平均成績為 {avg:.2f}')
但是,如果要計算 100 個學生的平均成績呢?要用 100 個變數嗎?這樣不但麻煩,程式碼也會很長。而且,如果題目是先告訴你有 N 個學生,N的值可能會變動,你要怎麼辦呢?
所以,我們需要一種能夠儲存大量資料的型別,這樣就可以用一個變數來儲存所有學生的成績,然後用迴圈來計算平均值。
13.2. 串列 List
List 為 Python 的核心功能之一,雖名為 List,實際為一種 dynamic array,即,在新增或移除元素時,Python 會負責調整 List 的儲存空間,動態配置或釋放記憶體。
如果你已經有 C/C++ 的背景,那麼你可以把 List 想像成一個陣列(array),但比陣列更強大,因為 List 可以儲存 不同類型 的資料,而陣列只能儲存 相同類型 的資料。
可以先想像為 C/C++的陣列,但裡面可以儲存 不同類型 的資料。
接下來的內容,我們會先假設你的程式裡已經有了 List 這樣的資料型別,並介紹如何使用它,之後再來介紹實際解決問題時要如何新建一個 List、並將資料讀入 List 中。
13.2.1. List 的基本概念
以下是 List 的基本概念:
- List 以[ ]將不同型態的資料含括起來,以 , 分隔,
- List 中的資料是有序排列,從 0 開始編號
- 指定語法: List 變數 = [ 元素 1, 元素 2, 元素 3, 元素 4, … ]
- 範例: data = [33, 95, 41, 45, 66, 88]
例如,我們在以下的程式中建立了一個 List 變數 data,並將 6 個整數放入其中:
1: data = [33, 95, 41, 45, 66, 88]
這樣一來,變數 data 就是一個 List,裡面有 6 個元素,分別是 33、95、41、45、66、88。
| data[0] | data[1] | data[2] | data[3] | data[4] | data[5] |
|---|---|---|---|---|---|
| 33 | 95 | 41 | 45 | 66 | 88 |
然後,我們可以用這樣的方式來取得List中的各項元素:
1: data = [33, 95, 41, 45, 66, 88]
2: print(f'data的第一個元素為 {data[0]}')
3: print(f'data的最後一個元素為 {data[-1]}')
第一個元素為 33
最後一個元素為 88
13.2.2. 對 List 中元素的修正
將資料放入 List 後,可以透過索引值來修改 List 中的元素。例如:
1: test = [12, 13, 14]
2: test[1] = 999
3: print(test)
[12, 999, 14]
13.2.3. List 中元素的存取與走訪
List 中的元素可以透過索引值來存取,索引值從 0 開始。例如,要存取 data 中的第一個元素,可以使用 data[0]、要存取第二個元素,可以使用 data[1],以此類推。
是不是有點熟悉的感覺?沒錯,我們之前在介紹字串(String)時,也有提到過類似的概念,字串中的每個字元也是有序排列的,可以透過索引值來存取。
例如:
1: data = [33, 95, 41, 45, 66, 88]
2: print(data[0]) #輸出第一個元素
3: print(data[3]) #輸出第四個元素
33
45
這麼看來,List 和字串有很多相似的地方,不過 List 更加靈活,因為它可以儲存不同類型的資料。
看到這裡,你應該可以想像 List+for 迴圈的組合,可以解決很多需要處理大量資料的問題了吧!例如:
1: data = [33, 95, 41, 45, 66, 88]
2: for i in range(len(data)):
3:     print(f'data[{i}] = {data[i]}')
data[0] = 33
data[1] = 95
data[2] = 41
data[3] = 45
data[4] = 66
data[5] = 88
這種行為我們就稱為「遍歷 List」,也有人叫做「走訪 List」,就是用迴圈一個一個地存取 List 中的每個元素。每當你學到一個新的資料型別時,都可以試著想想看,這個資料型別能不能跟 for 迴圈搭配起來使用,這樣你就能解決更多的問題了!
這種使用 range()和 len()來遍歷 List 的方式,在 Python 中非常常見,幾乎可以說是每個 Python 程式都會用到的技巧。另一種走訪 List 的方式是直接用 for element in list 的語法,這種方式更簡潔,也更符合 Python 的風格。例如:
1: data = [33, 95, 41, 45, 66, 88] 2: for element in data: 3: print(element)
33 95 41 45 66 88
除了走訪 List 之外,我們也可以對 list 中的元素進行加總,例如:
1: data = [33, 95, 41, 45, 66, 88] 2: tot = 0 3: for element in data: 4: tot += element 5: print(f'總和為 {tot}')
總和為 368
List 另一個強大之處在於可以和很多不同的函式搭配使用,例如 sum() 函式可以用來計算 List 中所有元素的總和,max() 函式可以用來找出 List 中的最大值,min() 函式可以用來找出 List 中的最小值。例如:
1: data = [33, 95, 41, 45, 66, 88] 2: print(f'總和為 {sum(data)}') 3: print(f'最大值為 {max(data)}') 4: print(f'最小值為 {min(data)}')
總和為 368 最大值為 95 最小值為 33
13.2.4. List 的專用函式
除了上述的函式之外,List 本身也有很多專用的函式,可以用來操作 List,例如 append() 函式可以用來在 List 的尾端新增一個元素,remove() 函式可以用來移除 List 中的某個元素,sort() 函式可以用來將 List 中的元素排序。
但是這些專用函式並不是像 len()、max() 那樣直接呼叫的內建函式,而是 List 物件自帶的方法(method),所以在使用時必須用 List變數.方法名稱() 的方式來呼叫(注意中間有個點號 . )。你可以這樣理解差異:
- 內建函式:=len(x)= → 把 x 丟進 len() 裡面
- List 方法:=x.append('F')= → 對 x 這個 List 呼叫它的 append 方法
例如:
<List>.clear()
清除表列中所有元素
1: x = ['A', 'B', 'C', 'D', 'E'] 2: x.clear() 3: print("清除後的表列:", x)
清除後的表列: []
<List>.index( 某元素 )
找出 某個元素 在 list 中的位置
1: x = ['A', 'B', 'C', 'D', 'E'] 2: print(x.index('C'))
2
<List>.append( 某元素 )
將 某元素 加到<List>尾端
1: x = ['A', 'B', 'C', 'D', 'E'] 2: x.append('F') 3: print("加入F後的表列:", x)
加入F後的表列: ['A', 'B', 'C', 'D', 'E', 'F']
<List>.extend(<List1>)
將<List1>合併至<List>尾端
1: x = ['A', 'B', 'C'] 2: y = ['D', 'E'] 3: x.extend(y) 4: print("合併後的表列:", x)
合併後的表列: ['A', 'B', 'C', 'D', 'E']
<List>.remove( 某元素 )
移除<List>中 某元素 元素(會花多一點的時間,移除 list 中間的元素後,要把後面的元素往前搬)
1: x = ['A', 'B', 'C', 'D', 'E'] 2: x.remove('C') 3: print("移除C後的表列:", x)
移除C後的表列: ['A', 'B', 'D', 'E']
<List>.insert(<i>, 某元素 )
將 某元素 加到<List>的索引值<i>位置
1: x = ['A', 'B', 'D', 'E'] 2: x.insert(2, 'C') 3: print("在索引2插入C後的列表:", x)
在索引2插入C後的列表: ['A', 'B', 'C', 'D', 'E']
<List>.reverse():
反轉表列元素
1: x = ['A', 'B', 'C', 'D', 'E'] 2: x.reverse() 3: print("反轉後的列表:", x)
反轉後的列表: ['E', 'D', 'C', 'B', 'A']
<List>.sort()
將表列中所有元素排序,語法如下:
1: List.sort(key=None, reverse=False)
- key: 可選參數,指定一個函數,用來從每個元素中提取比較的依據。例如
key=len就是依照元素長度來排序。 - reverse: 排序規則,reverse = True 降序, reverse = False 升序(預設值)。
1: x = [3, 1, 4, 1, 5, 9, 2] 2: x.sort() 3: print("升冪排序:", x) 4: x.sort(reverse = True) 5: print("降冪排序:", x)
升冪排序: [1, 1, 2, 3, 4, 5, 9] 降冪排序: [9, 5, 4, 3, 2, 1, 1]
<List>.count( 某元素 )
計算 list 中 某個元素 出現的次數
1: l = ['A', 'Q', 'S', 'A', 'Z'] 2: print(l.count('A'))
2
<List>.pop([index])
移除並回傳指定位置的元素。不指定 index 則移除最後一個元素。
1: x = ['A', 'B', 'C', 'D', 'E'] 2: last = x.pop() # 移除最後一個,回傳 'E' 3: print("pop():", last, x) 4: mid = x.pop(1) # 移除 index 1,回傳 'B' 5: print("pop(1):", mid, x)
pop(): E ['A', 'B', 'C', 'D'] pop(1): B ['A', 'C', 'D']
和 remove() 不同的是,pop() 是 用 index 移除 並且 會回傳被移除的值 ,而 remove() 是 用值來移除 且 不回傳 。
13.2.5. List 與字串
在 Python 中,很多不同的資料型別都可以互換,例如我們之前最常用的:
1: a = int(input())
就是將輸入的字串轉換成整數(int)型別,這樣我們就可以對變數 a 進行數學運算了。
同樣地,我們也可以將字串型別的資料轉為List
1: s = '339541456688' 2: data = list(s) 3: print(data)
['3', '3', '9', '5', '4', '1', '4', '5', '6', '6', '8', '8']
當字串被強制轉換成 List 時,List 中的每個元素就是字串中的每個字元。學會這個技巧後,你在面對需要處理字串的問題時,就可以更靈活地運用 List 來解決問題了!
13.2.6. List 的切片(slicing)
Python 的 List 雖然在概念上與 C++的陣列頗為相似,但在應用上則擁有更大的彈性,除了可以儲存不同類型的資料,最大的特色就是 Python 的 List 提供很強大的切片功能。
以下的範例是一些 List 切片的應用範例,不過如果你已經有了字串切片的概念,那麼你會發現 List 切片的用法幾乎是一模一樣的。這部份就可以參考前面介紹字串切片的內容,不用太認真看。
基本的 List sliceing
list slicing 是將 list 切出其中一部份
- 預設用法為 list[x:y]
- 區間定義為左閉右開(含左不含右)
- 負的 index 為倒數(自 list 尾端數過來)
1: list1 = [1, 2, 3, 4, 5, 6] 2: print(list1[2:4]) 3: print(list1[:3]) 4: print(list1[2:]) 5: print(list1[-2])
[3, 4] [1, 2, 3] [3, 4, 5, 6] 5
也可以對 list slice 賦值,即,將 list slice 放在等號左邊
1: list1 = [1, 2, 3, 4, 5, 6] 2: list1[:3] = [9, 9, 9] # [9, 9, 9]也可以寫成 [9] * 3 3: print(list1) 4: list1[:0] = [0, 0, 0] #詭異的插值方式1 5: print(list1) 6: list1[-1:] = [8, 8, 8] #詭異的插值方式2 7: print(list1)
[9, 9, 9, 4, 5, 6] [0, 0, 0, 9, 9, 9, 4, 5, 6] [0, 0, 0, 9, 9, 9, 4, 5, 8, 8, 8]
進階的 List slicing
不要故意把程式寫的太精簡詭異,也許日後自己會看不懂
1: list1 = [1, 2, 3, 4, 5, 6, 7, 8, 9] 2: print(list1[2:8:2]) 3: print(list1[::3]) 4: print(list1[::-1]) #反轉
[3, 5, 7] [1, 4, 7] [9, 8, 7, 6, 5, 4, 3, 2, 1]
13.2.7. List 的坑: list assign
List 雖然很好用,但也有一些需要注意的地方,否則很容易掉入陷阱。其中一個常見的陷阱就是 List 的賦值(assign)。
在 Python 中,當你寫 b = a 時,b 並不是 a 的「副本」,而是和 a 指向 同一份資料 。你可以把它想像成:a 和 b 是同一間房間的兩把鑰匙,不管你用哪把鑰匙進去改了房間裡的東西,另一把鑰匙打開看到的都是改過的結果。
1: a = [1, 2, 3] 2: b = a # b 和 a 指向同一個 List 3: a[2] = 100 # 透過 a 改了第三個元素 4: print(a) # a 變了 5: print(b) # b 也跟著變了!因為它們是同一個 List
[1, 2, 100] [1, 2, 100]
這和整數、字串的行為不同(因為整數和字串是不可變的),是 Python 初學者最容易踩到的坑之一。
若真要複製一份獨立的 List,有兩種做法(兩者都是淺拷貝 shallow copy,只複製第一層元素;如果 List 裡面還有 List,內層仍然是共用的):
1: a = [1, 2, 3] 2: b = a.copy() 3: c = a[:] 4: a[2] = 100 5: print(a) 6: print(b) 7: print(c)
[1, 2, 100] [1, 2, 3] [1, 2, 3]
list assign, is, ==
既然講到 list 的 assign(b=a),我們就順便來講講 Python 的一個有趣小常識:== v.s. is,在 Python 中,is 和 == 都用來比較,但用途和比較的內容完全不同:
| 比較運算子 | 用途 | 比較的是 | 適用情境範例 |
|---|---|---|---|
| == | 值是否相等 | 兩個物件的「值」 | 數值、字串、列表等 |
| is | 是否為同一個物件 | 兩個物件的「身份 ID」 | 是否為同一個實體物件 |
換言之,==在於判斷值相等(value equality);而 is 在判斷身份相等(identity equality),也就是(記憶體位址相同)
舉例來說,底下有兩個變數,其內容(值)相等
1: a = [1, 2, 3] 2: b = [1, 2, 3] 3: print(a == b) # True,因為內容一樣 4: print(a is b) # False,因為兩個變數指向不同的物件
True False
另一個例子是,當我們用 a = b 這種方式來賦值時,a 和 b 其實是指向同一個物件,所以
1: a = [1, 2, 3] 2: b = a 3: print(a == b) # True,因為內容一樣 4: print(a is b) # True,因為兩個變數指向同一個物件
True True
這樣,你學廢了嗎?
13.2.8. 如何建立一個 List
介紹完 List 的基本概念與操作後,接下來要介紹如何建立一個 List 以及如何將資料讀入 List 中。作業裡很多題目都需要用到 List 來儲存大量的資料,所以這部份的內容非常重要,請務必仔細閱讀並理解。
建立空的 List
建立 List 的第一步,當然是要先建立一個空的 List 變數,可以用下列語法:
1: testl = []
為 List 加入 element
接下來就可以用 append() 函式或 += 運算子來將 element 加入 List 中。例如:
1: testl = [] 2: testl.append(1) 3: testl.append(2) 4: testl += [3] 5: print(testl)
[1, 2, 3]
把一串輸入值存入 List 中
要讀入的資料可能是逐列輸入,也可能是以空白間隔的方式輸入,以下分別介紹這兩種情況如何將輸入值存入 List 中。
- 如果輸入是逐列輸入,共有 5 列
1: ''' 2: 23 3: 45 4: 61 5: 32 6: 33 7: ''' 8: testl = [] 9: for i in range(5): 10: testl.append(input())
- 如果輸入是在一列,以空白間隔
1: ''' 2: 輸入:23 45 61 32 33 3: ''' 4: testl1 = input().split()
有沒有發現,其實我們之前一直在使用的 input().split() ,其結果就是一個 List,只不過裡面的元素都是字串而已。只是我們之前沒有介紹到 List,所以先讓大家以多個變數來接收這些輸入值罷了。例如:
1: a, b, c = input().split()
但是像上面這樣把用 input().split()所建立的 List,其元素都是字串,如果要把它們轉成整數,還需要再做一次轉換,例如:
1: testl1 = list(map(int, input().split()))
這樣就可以把輸入的字串轉成整數,並存入 List
為什麼在 map()外面還要再用 list()包起來呢?因為 map() 函式會回傳一個 map 物件,而不是 List,所以我們需要用 list() 函式將 map 物件轉成 List。
13.2.9. 判斷 list 中有沒有某個元素
可以用 in 或 not in 來判斷,例如:
1: x = ['A', 'B', 'C', 'D', 'E'] 2: if 'B' in x: 3: print('list裡有B') 4: if 'Q' not in x: 5: print('list裡沒有Q')
list裡有B list裡沒有Q
13.2.10. List 的另一個坑: 走訪 List 時修改元素
有時候我們會需要在走訪 List 時,同時修改 List 中的元素(尤其是刪除元素),這時候就要特別小心,否則很容易出錯。 例如,下面的程式碼試圖把不及格的分數從 List 中刪除:
1: a = [75, 49, 33, 82, 90] 2: for x in a: 3: if x < 60: 4: a.remove(x) 5: print(a)
[75, 33, 82, 90]
咦?33 明明不及格,卻沒有被刪掉!
這是因為在走訪 List 時,同時修改 List 中的元素,會導致迴圈的行為變得不可預期。for 迴圈其實是靠一個「目前走到第幾個」的索引在依序取出元素:第 0 圈取 index 0、第 1 圈取 index 1……。當我們在第 1 圈刪掉 49 之後,後面的元素全部往前補位,33 跑到了 index 1,但迴圈接著要取的是 index 2(已經變成 82),於是 33 就被跳過了。只要有 相鄰 的兩個元素都該刪,就一定會漏掉一個。
以 for 來走訪 list 時,list 中的元素是 for 迴圈重複的重要依據,一邊依賴 list 來執行迴圈,一邊又在執行時去刪除 list 中的元素,就像一邊過橋一邊拆橋,行為的結果自然難以預期。
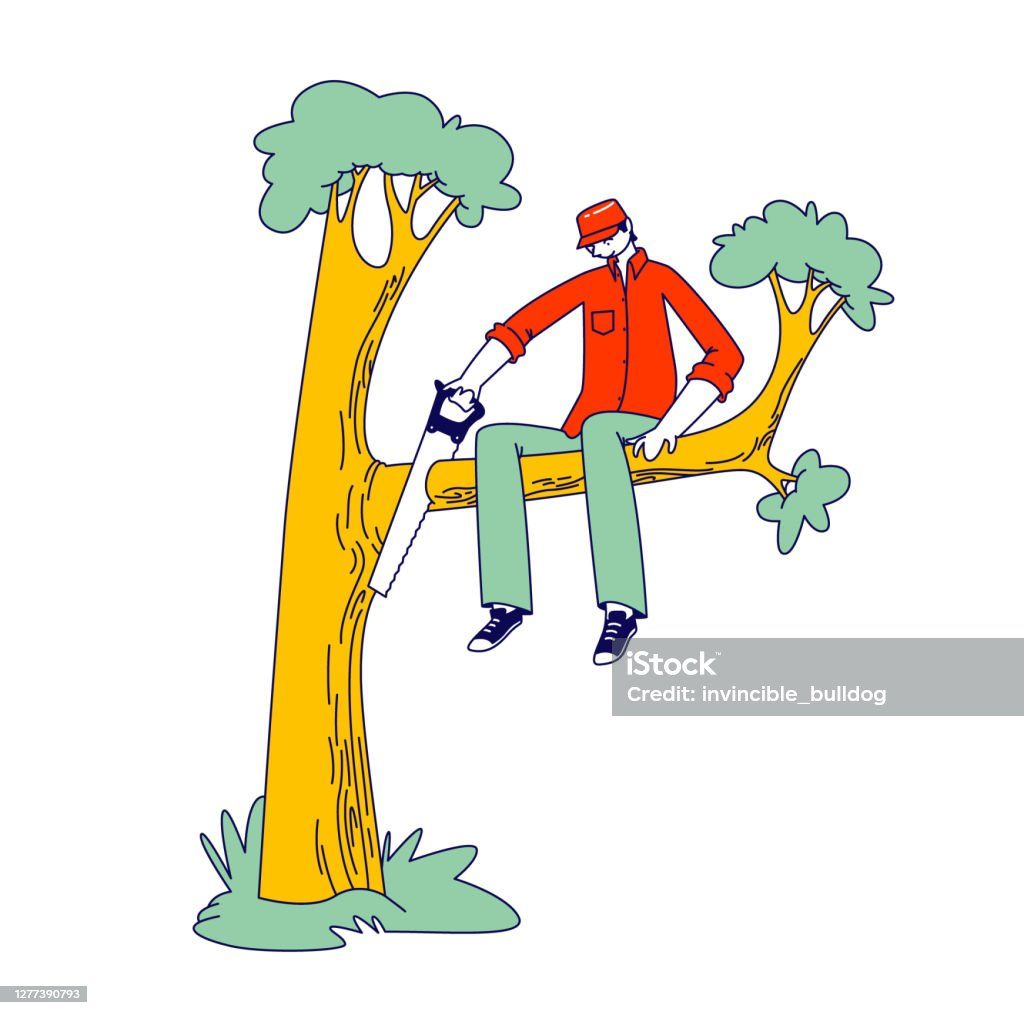
為了避免這種情況,我們可以採用以下幾種方法來解決這個問題(這部份內容請自行閱讀):
使用 List comprehension 來建立一個新的 List,只包含我們想要保留的元素。例如:
1: a = [75, 82, 49, 90, 33, 67] 2: a = [x for x in a if x >= 60] 3: print(a)
[75, 82, 90, 67]
使用反向迴圈來走訪 List,這樣在刪除元素時就不會影響到尚未走訪的元素。例如:
1: a = [75, 82, 49, 90, 33, 67] 2: for i in range(len(a)-1, -1, -1): 3: if a[i] < 60: 4: del a[i] 5: print(a)
[75, 82, 90, 67]
使用 while 迴圈來走訪 List,並在刪除元素後調整索引值。例如:
1: a = [75, 82, 49, 90, 33, 67] 2: i = 0 3: while i < len(a): 4: if a[i] < 60: 5: del a[i] 6: else: 7: i += 1 8: print(a)
[75, 82, 90, 67]
13.2.11. '[sep]'.join( <List>)
join() 可以把一個 List 裡的字串元素全部「黏」成一個字串,中間用你指定的分隔符隔開。
注意它的語法可能和你預期的不一樣:不是 List.join(分隔符) ,而是 分隔符.join(List) 。也就是說,join() 是 字串 的方法,不是 List 的方法。你可以這樣記:「用什麼分隔符來 join 這個 List」。
另外要注意:List 裡的元素必須 全部都是字串 ,如果有數字就會出錯。
1: words = ['Hello', 'world', 'Python'] 2: result = ' '.join(words) 3: print(result) 4: # 用不同的分隔符 5: print(', '.join(words)) 6: print('-'.join(words)) 7: # 不用分隔符(直接串接) 8: print(''.join(words))
Hello world Python Hello, world, Python Hello-world-Python HelloworldPython
join() 可以想成是 split() 的反操作:split() 把字串拆成 List,join() 把 List 合成字串。
13.2.12. 課堂練習
將以下 List 複製貼上至程式碼中
scores = [78, 12, 97, 45, 12, 45, 98, 100, 9, 23]
輸出以下資訊
- 全班平均:至小數點第 2 位
- 全班最高分分數
- 全班最低分分數
13.2.13. zip()
zip 與 for 迴圈
在 Python 中若要將兩個 List 以迴圈的方式一次各取一個元素出來處理,可以使用 zip 打包之後配合 for 迴圈來處理,如下例
1: # 第一個 List 2: names = ["A", "B", "C"] 3: 4: # 第二個 List 5: values = [11, 23, 46] 6: 7: # 使用 zip 同時迭代兩個 List 8: for x, y in zip(names, values): 9: print(x, y)
這裡的 zip(names, values) 會將 names 與 values 的每個元素以一對一的方式配對起來,組成一個新的迭代器,然後交給 for 迴圈進行迭代,所以每一次迭代時所取的 x 值會來自於 names,而 y 則會來自於 values9。結果如下:
A 11 B 23 C 46
不同長度的 Lists
zip 若遇到不同長度的 List 時,會以長度最短的 List 為準,超過長度的部分就會被捨棄。zip 也可應用於兩個以上的 List,如:
1: # 多個 Lists 2: names = ["A", "B", "C"] 3: values = [11, 23, 46] 4: ages = [45, 67, 82] 5: 6: # 使用 zip 同時迭代多個 List 7: for x, y, z in zip(names, values, ages): 8: print(x, y, z)
13.2.14. List 練習
- 連續輸入成績(輸入-1 結束),將成績由高至低排序輸出,並輸出總分、平均
1: score = [] 2: while(True): 3: sc = int(input()) 4: if (sc != -1): 5: score.append(sc) 6: else: 7: break 8: score.sort(reverse=True) 9: print(score) 10: sos = sum(score) 11: print(f'全班總分:{sos},全班平均:{sos/len(score):.2f}')
- 連續輸入成績(加入提示字元)
1: total = 0 2: grades = [] 3: for i in range(0, 5): 4: x = int(input("請輸入第" + str(i + 1) + "個成績: ")) 5: grades.append(x) 6: total += x 7: print(total/5) 8: print(grades)
13.2.15. 課堂練習
- 給定兩個 List,同時走訪兩個 List,List1 以正向順序顯示,List2 以反向順序顯示
- 範例:
Input: [可以將輸入直接複製貼上到 code 中] List1 = [10, 20, 30, 40] List2 = [100, 200, 300, 400] Output: 10 400 20 300 30 200 40 100
13.2.16. 作業
lone wolf
讀入一整數 n、接下來讀入 n 個整數,列出這幾個整數中未成對者
- Examples
Input: 3 2 2 1 Output: 1 Input: 5 4 1 2 1 2 Output: 4
removing the Nth occurence element
- 讀入一字串
- 再讀入一 word x, 一整數 n (n<字串長度),刪除上述字串中第 n 個重複出現的 x
- 輸出剩下的字串
Examples
Input: to be or not to be, that is the question. be 2 Output: to be or not to, that is the question.
Maximum Subarray
給定一組整數 List,找出 List 中一個具有最大總和的連續子 List(至少包含一個數字),並傳回該子 List 總和。
- 輸入範例及測資
測資 1
1: -2 1 -3 4 -1 2 1 -5 4
可以用以下程式碼讀入測資
1: nums = list(map(int, input().split()))
測資 1 答案
1: 6 - 提示
如果我們從第 1 個值開始算起:
- 子 List [-2]:和為 -2
- 子 List [-2, 1]:和為 -1
- 子 List [-2, 1, -3]:和為 -4
- 子 List [-2, 1, -3, 4]:和為 0
- 子 List [-2, 1, -3, 4, -1]:和為 -1
- 子 List [-2, 1, -3, 4, -1, 2]:和為 1
- 子 List [-2, 1, -3, 4, -1, 2, 1]:和為 2
- 子 List [-2, 1, -3, 4, -1, 2, 1, -5]:和為 -3
- 子 List [-2, 1, -3, 4, -1, 2, 1, -5, 4]:和為 1
這是一個經典的最大子陣列問題,我們必須考慮所有可能的子數組,並計算每個子數組的總和。然後,從所有子數組的和中選擇一個最大的值。
- 子 List [-2]:和為 -2
SD
標準差(又稱標準偏誤、均方差,英語:Standard Deviation,縮寫 SD),數學符號σ(sigma),在機率統計中最常使用作為測量一組數值的離散程度之用。標準差定義:為變異數開主平方根,反映組內個體間的離散程度;標準差與期望值之比為標準離差率。測量到分布程度的結果,原則上具有兩種性質:
- 為非負數值(因為開平方後再做平方根);
- 與測量資料具有相同單位(這樣才能比對)
- 標準差的公式如下
\[SD= \sqrt{\frac{1}{N} \sum_{i=1}^N (x_i - \mu)^2} \]
\[\mu=\bar{x} \] - 輸入:n個整數,為該班資訊科期中考分數,以空白間隔。但是因為出題者產生測資時不太小心,導致這些空白不太一致,有的有一個空白,有的數字間有兩個空白,有的有三個,然後出題者又因為太懶不想逐一去修改,所以請你自己解決這件麻煩的事….
- 輸出:該班資訊科期中考標準差,到小數點第三位
13.2.17. List comprehension
以描述 List 內容的方式來建構一個 list,即,把 for 內含在 list 建構中
\[S = \{x \mid 0\leq x < 10, x \in \mathbb{Z}\}\]
1: a = [x for x in range(10)] 2: print(a)
[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
上面的 code 可以取代以下的寫法
1: a = [] 2: for i in range(10): 3: a.append(i)
另外較複雜的例子
1: a = [x for x in range(10)] 2: c = [x**3 for x in a] 3: print(c) 4: d = [(x, y) for x in [1, 2, 3] for y in [3, 1, 4] if x != y ] 5: print(d)
[0, 1, 8, 27, 64, 125, 216, 343, 512, 729] [(1, 3), (1, 4), (2, 3), (2, 1), (2, 4), (3, 1), (3, 4)]
13.2.18. List 與字串
字串內容無法改變,例
1: s = 'abc' 2: s[1] = 'q'
結果
TypeError: 'str' object does not support item assignment
則可以改為
1: s = 'abc' 2: t = s[:1]+'q'+s[2:] 3: print(t)
aqc
也可以將字串改成 list,直接改 list
1: s = 'abc' 2: t = [x for x in s] 3: print(t) 4: t[1] = 'q' 5: for x in t: 6: print(x, end='')
['a', 'b', 'c'] aqc
13.2.19. sort() v.s. sorted()
這兩個都可以用來排序,但有一個重要差異:
sort()是 List 的方法(method),會 直接修改 原本的 List,沒有回傳值(回傳 None)。sorted()是 Python 的內建函式,會回傳一個 新的排序後 List ,原本的 List 不會被改變。
簡單來說:如果你想保留原本的順序,就用 sorted();如果不需要保留,就用 sort()。
1: a = [3, -4, 100, 20, 999] 2: b = sorted(a) #不會改變a原本的內容 3: print('a:', a) 4: print('b:', b) 5: a.sort() #a原本的內容被改了 6: print('a:', a)
a: [3, -4, 100, 20, 999] b: [-4, 3, 20, 100, 999] a: [-4, 3, 20, 100, 999]
13.2.20. SORT using lambda
如果要對二維 List 排序,Python 預設會先用每個子 List 的第一個元素來比,第一個元素相同時再比第二個,依此類推。但如果你想指定用第幾個元素來排序呢?這時可以用 key 參數搭配 lambda 。
lambda 是一種「匿名函式」的寫法,語法是 lambda 參數: 運算式 ,它會回傳運算式的結果。例如 lambda x: x[0] 的意思是「給我一個東西 x,我回傳 x[0]」。所以 key = lambda x: x[0] 就是告訴 sort():「排序時,請用每個元素的第 0 個值來比大小」。
lambda 小檔案
- 語法:
lambda args: expression- 就是一個沒有名字的小函式,只能寫一行運算式
- 常搭配
sort(key…)= 、map()、filter()使用- 例如
lambda x, y: x + y等同於寫一個兩數相加的函式
lambda 的詳細用法會在進階教材中介紹。
1: a = [[1, 3], [2, 1], [2, 4], [-3, 6]] 2: a.sort(key = lambda x: x[0]) #取出x[0]做為比較對象 3: print(a) 4: a.sort(key = lambda x: x[1]) 5: print(a)
[[-3, 6], [1, 3], [2, 1], [2, 4]] [[2, 1], [1, 3], [2, 4], [-3, 6]]
13.3. 二維 List
前面提到 list 的元素可以是整數、小數、字串,更重要的是 list 的元素也可以是另一個 list,這就是以前 C++裡所看到的二維陣列的概念了…
二維 list 範例
1: demoList = [[1, 2, 3], [4, 5, 6]] 2: print(demoList) 3: print(demoList[0]) #取出第一個子List 4: print(demoList[0][1]) #取出第一個子List中的第二個element
[[1, 2, 3], [4, 5, 6]] [1, 2, 3] 2
不同型態的二維 List
1: #全班三科成績列表,求每個人平均 2: demoList = [['James', 90, 77, 55], 3: ['Vanessa', 96, 78, 88], 4: ['Ruby', 88, 77, 66]] 5: for user in demoList: 6: print(f'{user[0]:7s}: {sum(user[1:])/3:.4f}') 7: #print(user[0], sum(user[1:])/3))
James : 74.0000 Vanessa: 87.3333 Ruby : 77.0000
課堂練習:
複製下列程式碼
1: demoList = [['James', 90, 77, 55], 2: ['Vanessa', 96, 78, 88], 3: ['Ruby', 88, 77, 66]]
以如下格式(文字要向右對齊)輸出前例中全班三科平均成績
James: 74.00 Vanessa: 87.33 Ruby: 77.00
二維 List traversal
- solution 1
1: demoList = [[1, 2, 3], [4, 5, 6]] 2: for subList in demoList: 3: for element in subList: 4: print(element, end=' ') 5: print()
1 2 3 4 5 6
- solution 2
1: #用這個方式排版可以更清楚看出二維List的架構 2: demoList = [[1, 2, 3], 3: [4, 5, 6]] 4: for row in range(len(demoList)): 5: for col in range(len(demoList[0])): 6: print(demoList[row][col], end=' ') 7: print()
1 2 3 4 5 6
如何建立一個二維 List
- 先建立一個空的 List
- 不斷 append 子 List
1: my2DList = [] 2: 3: # 建一子List 4: x = [] 5: x.append(12) 6: x.append(24) 7: x.append(88) 8: #將子List加入my2dList 9: my2DList.append(x) 10: 11: # 再建一子List 12: x = [] 13: x.append(33) 14: x.append(99) 15: x.append(12) 16: #再將子List加入my2dList 17: my2DList.append(x) 18: 19: print(my2DList) 20:
[[12, 24, 88], [33, 99, 12]]
上述動作可以用 for 來完成:
1: my2DList = [] 2: # 依序輸入12, 24, 88, 33, 99, 12 3: for i in range(2): 4: x = [] 5: for j in range(3): 6: x.append(int(input())) 7: my2DList.append(x)
有發現一件事嗎?在上面的程式碼中,變數 i,j 其實用處不太大,在生成兩個數列(range(2)、range(3))後就沒什麼作用了,所以這兩個變數給什麼名字都無所謂,如果你懶的替這種沒什麼重要性的變數取名字,也可以用_來取代,將上述程式改為:
1: for _ in range(2): 2: x = [] 3: for _ in range(3): 4: x.append(int(input())) 5: my2DList.append(x)
初始化一個 3*4(row * column)、內容都是 0 的 List
要創建一個 3 列、每列 4 個 0 的二維 list 有很多種方式..
- 正規作法
1: a = [] 2: for _ in range(3): 3: x = [] 4: for _ in range(4): 5: x.append(0) 6: a.append(x) 7: print(a) 8: a[0][1] = 9 9: print(a)
[[0, 0, 0, 0], [0, 0, 0, 0], [0, 0, 0, 0]] [[0, 9, 0, 0], [0, 0, 0, 0], [0, 0, 0, 0]]
- 簡單不易懂版本
1: a = [[0]*4 for i in range(3)] 2: print(a) 3: a[0][1] = 9 4: print(a)
[[0, 0, 0, 0], [0, 0, 0, 0], [0, 0, 0, 0]] [[0, 9, 0, 0], [0, 0, 0, 0], [0, 0, 0, 0]]
- 錯誤作法
以下的寫法是 錯的 錯的 錯的
1: a = [[0]*4]*3 2: print(a) 3: a[0][1] = 9 #這裡會一次改掉三個值 4: print(a)
[[0, 0, 0, 0], [0, 0, 0, 0], [0, 0, 0, 0]] [[0, 9, 0, 0], [0, 9, 0, 0], [0, 9, 0, 0]]
為什麼三列都被改了?因為
[[0]*4]*3裡的*3並不是複製了三份獨立的 List,而是讓三個位置都指向 同一個[0,0,0,0](和前面提到的 List assign 陷阱一樣)。所以改了其中一個,三個都會跟著變。這就是為什麼要用 for 迴圈或 list comprehension 來建立二維 List,確保每一列都是獨立的。
課堂練習
以 for 迴圈生成一個如下的二維 List(append)
[[0, 1, 2], [1, 2, 3], [2, 3, 4], [3, 4, 5], [4, 5, 6]]
13.4. 元組 tuple
Tuple(元組)和 List 很像,都可以用來儲存多個資料,也都可以用 index 來存取元素。最大的差別在於:Tuple 一旦建立後,裡面的元素就 不能修改 (immutable),而 List 是可以修改的(mutable)。
什麼時候該用 Tuple 而不是 List 呢?當你確定這組資料不應該被修改時(例如一週的七個星期名稱、某個座標 (x, y)),就適合用 Tuple,這樣可以避免不小心改到資料。
至於 Tuple 要如何唸? Python 作者 Guido 是這麼說的10:
I pronounce tuple too-pull on Mon/Wed/Fri and tub-pull on Tue/Thu/Sat. On Sunday I don't talk about them. :)
13.4.1. 資料格式
- 資料格式:以( )將不同型態的資料含括起來,以 , 分隔
- 元組中的資料是有序排列,從 0 開始編號
- 語法: tuple 變數 = ( 元素 1, 元素 2, 元素 3, 元素 4, … )
範例: data = (33, 95, 41, 'TEST', 99, [123, 456])
data[0] data[1] data[2] data[3] data[4] data[5] 33 95 41 TEST 99 [123, 456] - tuple 與 List 類似,但 tuple 內的元素不能修改
13.4.2. 建立 Tuple
建立 Tuple 的方式是把所有元素放在小括號 () 裡面,以逗號分隔。小括號其實可以省略,但建議還是加上去比較清楚。
1: # Different types of tuples 2: 3: # Empty tuple 4: my_tuple = () 5: print(my_tuple) 6: 7: # Tuple having integers 8: my_tuple = (1, 2, 3) 9: print(my_tuple) 10: 11: # tuple with mixed datatypes 12: my_tuple = (1, "Hello", 3.4) 13: print(my_tuple) 14: 15: # nested tuple 16: my_tuple = ("mouse", [8, 4, 6], (1, 2, 3)) 17: print(my_tuple) 18: 19: tup1 = (53, ) #只有一個元素時,其後要加逗號 20: print(tup1) 21:
()
(1, 2, 3)
(1, 'Hello', 3.4)
('mouse', [8, 4, 6], (1, 2, 3))
(53,)
13.4.3. 存取 Tuple 元素
正向索引 (Indexing)
和 List 一樣,可以用中括號 [] 加上 index 來存取 Tuple 中的元素,index 從 0 開始。
1: # Accessing tuple elements using indexing 2: my_tuple = ('p','e','r','m','i','t') 3: 4: print(my_tuple[0]) # 'p' 5: print(my_tuple[5]) # 't' 6: 7: # IndexError: tuple index out of range 8: # print(my_tuple[6]) 9: 10: # Index must be an integer 11: # TypeError: tuple indices must be integers or slices, not float 12: # my_tuple[2.0] 13: 14: # nested tuple 15: n_tuple = ("mouse", [8, 4, 6], (1, 2, 3)) 16: 17: # nested index 18: print(n_tuple[0][3]) # 's' 19: print(n_tuple[1][1]) # 4
p t s 4
反向索引 (Negative Indexing)
和 List、字串一樣,Tuple 也支援負數索引,-1 表示最後一個元素、-2 表示倒數第二個,以此類推。
1: # Negative indexing for accessing tuple elements 2: my_tuple = ('p', 'e', 'r', 'm', 'i', 't') 3: 4: # Output: 't' 5: print(my_tuple[-1]) 6: 7: # Output: 'p' 8: print(my_tuple[-6])
t p
切片(Slicing)
和 List 一樣,Tuple 也支援切片操作,可以用冒號 : 來取出一段範圍的元素。切片的規則同樣是「左閉右開」——包含起始索引,不包含結束索引。
1: # 用切片取出 Tuple 中的元素 2: my_tuple = ('p','r','o','g','r','a','m','i','z') 3: 4: # 取出索引 1 到 3 的元素(不含索引 4) 5: print(my_tuple[1:4]) # ('r', 'o', 'g') 6: 7: # 從開頭取到倒數第 7 個之前 8: print(my_tuple[:-7]) # ('p', 'r') 9: 10: # 從索引 7 取到最後 11: print(my_tuple[7:]) # ('i', 'z') 12: 13: # 取出全部元素(相當於複製一份) 14: print(my_tuple[:]) # ('p', 'r', 'o', 'g', 'r', 'a', 'm', 'i', 'z')
('r', 'o', 'g')
('p', 'r')
('i', 'z')
('p', 'r', 'o', 'g', 'r', 'a', 'm', 'i', 'z')
Tuple 的方法(Methods)
因為 Tuple 是不可變的,所以沒有新增或刪除元素的方法。Tuple 只提供以下兩個方法:
- ~count(x)~:計算元素 x 在 Tuple 中出現的次數
- ~index(x)~:回傳元素 x 第一次出現的索引位置
1: my_tuple = ('a', 'p', 'p', 'l', 'e',) 2: 3: print(my_tuple.count('p')) # Output: 2 4: print(my_tuple.index('l')) # Output: 3
2 3
Tuple 遍歷
用 for 迴圈可以逐一取出 Tuple 中的每個元素:
1: # 用 for 迴圈遍歷 Tuple 2: for name in ('John', 'Kate'): 3: print("Hello", name)
Hello John Hello Kate
13.4.4. 練習
修改 Tuple 中的 List 元素
雖然 Tuple 本身不可變,但如果 Tuple 裡面包含一個 List,那個 List 的內容是可以修改的。以下範例將 Tuple 中 List 的第一個元素從 22 改為 222:
tuple1 = (11, [22, 33], 44, 55) Expected output: tuple1 = (11, [222, 33], 44, 55)
1: tuple1 = (11, [22, 33], 44, 55) 2: tuple1[1][0] = 222 3: print(tuple1)
(11, [222, 33], 44, 55)
練習: 史上最強掌法
自從鐵掌無敵馬掌門出任武林盟主後,綠林豪傑一片哀鴻,民不聊生,痛苦指數破表,眾家名門弟子甚至遠避異鄉以求溫飽。近來馬掌門更獨創「油電雙掌」,以圖鞏固武林領導地位,此套掌法高深莫測,武林中人聞風喪膽,少林、武當各派高手不得不拋開門戶之見,齊聚「竹園崗」合作商議對策。目前僅由歷來幾次掌下逃生者的對戰經驗分析出以下數據
| 與馬掌門對戰時間(秒) | 對戰者每秒接受之傷害值 |
|---|---|
| 120 以下 | 2.10 |
| 121~330 | 3.02 |
| 331~500 | 4.39 |
| 501~700 | 4.97 |
| 701 以上 | 5.63 |
請你幫這些可憐的高手寫一個程式分析對戰時間與受傷指數間的關係。
輸入:0 ~ 10000 秒之間任意值
輸出:受傷指數
- 解 1
1: #sec = input() 2: sec = 800 3: if sec <= 120: 4: print(sec*2.10) 5: elif sec > 120 and sec <= 330: 6: print(120*2.10+(sec-120)*3.02) 7: elif sec > 330 and sec <= 500: 8: print(120*2.10+(330-120)*3.02+(sec-330)*4.39) 9: elif sec > 500 and sec <= 700: 10: print(120*2.10+(330-120)*3.02+(500-330)*4.39+(sec-500)*4.97) 11: elif sec > 700: 12: print(120*2.10+(330-120)*3.02+(500-330)*4.39+(700-500)*4.97+(sec-700)*5.63)
3189.5
- 解 2
1: #sec = input() 2: sec = 800 3: hurt = 0 4: gap = (700, 500, 330, 120, 0) 5: rate = (5.63, 4.97, 4.39, 3.02, 2.10) 6: for i in range(5): 7: if sec > gap[i]: 8: hurt += (sec-gap[i])*rate[i] 9: sec = gap[i] 10: print(hurt)
3189.5
13.5. List v.s. Tuple
二者的差異與適用時機:
13.5.1. 能否改變內容
- 使用 Tuple 而非 List,等於告訴讀程式的人(和 Python 直譯器):「這組資料不應該被修改」。這在程式中是一個很有用的暗示,可以避免不小心改到不該改的資料。
13.5.2. 可讀性
當 Tuple 放在 List 裡面時,閱讀起來比巢狀 List 更容易辨識。例如:
1: [(2,4), (5,7), (3,8), (5,9)]比起下面這種寫法更容易一眼看出每組資料的邊界:
1: [[2,4], [5,7], [3,8], [5,9]]
13.5.3. Tuple 與 dict 的關係
Tuple 常被當作「沒有 key 的字典」來存資料,例如用 Tuple 來存電影的(片名, 導演, 年份):
1: [('Swordfish', 'Dominic Sena', 2001), ('Snowden', ' Oliver Stone', 2016), ('Taxi Driver', 'Martin Scorsese', 1976)]
- 上面的範例是一個 List,裡面裝了多個 Tuple,每個 Tuple 代表一部電影的資訊。
- 另外,Tuple 因為不可變,所以可以當作字典的 key 來使用;但 List 是可變的,不能當 key。
1: key_val= {('alpha','bravo'):123} #Valid 2: #key_val = {['alpha','bravo']:123} #Invalid 3: print(key_val) 4: print(key_val.keys()) 5: print(key_val.values())
{('alpha', 'bravo'): 123}
dict_keys([('alpha', 'bravo')])
dict_values([123])
14. 資料型別-集合 set
14.1. 資料格式
- 資料格式:以{}將各組資料含括起來,以','分隔,或以 set()建立
- 集合中的資料是無序的,會自動刪除重複元素
格式
1: 集合名稱 = {元素1, 元素2, … }
- 註:set(<seq>)函式的參數<seq>可為字串、表列、元組、字典
14.2. 空集合
如果你要建立空集合,不可以直接使用 {}~,因為 Python 會把 ~{} 當成空字典(dict),而不是空集合。要建立空集合,必須使用 set()11。例如:
1: family = set() 2: family.add("James") 3: family.add("Vanessa") 4: print(family)
{'James', 'Vanessa'}
14.3. 範例
1: S1 = { 'John', 95, 'May', 100, 'John' } 2: print(S1) # 'John' 只會出現一次 3: S2 = set('apple') # 集合的資料是無序的 4: print(S2) # {'l', 'a', 'e', 'p'}
14.4. 元素新增刪除
1: <set>.add(<item>) 2: <set>.remove(<item>)
- remove()若無此 item 會發生錯誤
1: s = set('apple') 2: s.add('x') 3: print(s) 4: s.remove('p') 5: print(s)
{'e', 'p', 'x', 'l', 'a'}
{'e', 'x', 'l', 'a'}
14.5. 集合可使用函式
與串列 (List) 和數組 (Tuple) 一樣可以使用以下函式12
set(): 把資料換為 set 型態
1: List1 = ['A', 'B', 'C'] 2: set1 = set(List1) 3: print(set1)
{'C', 'B', 'A'}len(): 回傳長度
1: # 計算 Set 的長度 2: set1 = {'C', 'B', 'A'} 3: print(len(set1))
sum(): 回傳總和
1: # 計算 Set 中數字的總和 2: set2 = {1, 2, 3, 4, 5} 3: print(sum(set2))
- max(): 回傳最大值
min(): 回傳最小值
1: set2 = {1, 2, 3, 4, 5} 2: print("最大值:", max(set2)) 3: print("最小值:", min(set2))
14.6. 判斷某 element 是否存在於 set 中
與串列 (List) 和數組 (Tuple) 一樣可以使用 in 和 not in 來判斷元素是否存在於集合中
1: set1 = {2, 4, 6, 8, 10} 2: 3: print(2 in set1) 4: print(11 in set1) 5: print(3 not in set1) 6: print(4 not in set1)
True False True False
14.7. 遍歷 set
因為集合 (Set) 沒辦法使用索引 (Index) 來印出, 所以用 for 迴圈寫時要這樣寫
1: set1 = {2, 4, 6, 8, 10} 2: 3: for i in set1: 4: print(i, end = ' ')
2 4 6 8 10
14.8. 集合運算
集合支援數學上常見的集合運算:
| 運算 | 符號 | 說明 |
|---|---|---|
| 聯集 | | | 兩個集合的所有元素合在一起(去重複) |
| 交集 | & | 兩個集合都有的元素 |
| 差集 | - | 在 a 但不在 b 的元素 |
| 對稱差集 | ^ | 只在其中一個集合出現的元素(互斥的部分) |
| 屬於 | in | 判斷某元素是否在集合中 |
1: a = {'a', '2', '3', '4'} 2: b = set('357') 3: print("a | b:", a | b) 4: print("a & b:", a & b) 5: print("a - b:", a - b) 6: print("a ^ b:", a ^ b) 7: print("'5' in a:", '5' in a) 8: print("'5' in b:", '5' in b)
a | b: {'a', '4', '3', '2', '5', '7'}
a & b: {'3'}
a - b: {'a', '4', '2'}
a ^ b: {'a', '2', '5', '4', '7'}
'5' in a: False
'5' in b: True
14.9. 練習
從 set1 中只保留 set1 和 set2 的共同元素(取交集)
set1 = {10, 20, 30, 40, 50}
set2 = {30, 40, 50, 60, 70}
Expected output:
{40, 50, 30}
14.10. 作業[set]
14.10.1. 測資讀取的方式
14.10.2. 你快樂嗎?我很快樂
快樂數有以下的特性:在給定的進位制下,該數字所有數位(英語:digits)的平方和,得到的新數再次求所有數位的平方和,如此重複進行,最終結果必為 1。 13
- 輸入任一整數,回傳 Happy/Unhappy 來說明這個數是否快樂。
- Examples:
Input: 28 Output: Happy Input: 4 Output: Unhappy
14.10.3. unique character in string check set
讀入字串若干行(我也不知道有幾行),每行代表一集合。輸出所有集合的交集項目數與聯集項目數。
A,B,D,X,Q,M,G,C
B,C,Y,N,M,L,H
Q,C,Y,M,D,H
14.10.4. word frequency dict
讀入一段字,輸出所有字的頻率
14.10.5. Coterie
題目
- 說明
- Q 同學正在學習程式,P 老師出了以下的題目讓他練習。
- 一群人在一起時經常會形成一個一個的小群體。假設有 N 個人,編號由 0 到 N-1,每個人都寫下他最好朋友的編號(最好朋友有可能是他自己的編號,如果他自己沒有其他好友),在本題中,每個人的好友編號絕對不會重複,也就是說 0 到 N-1 每個數字都恰好出現一次。
這種好友的關係會形成一些小群體。例如 N=10,好友編號如下:
編號 同學 0 1 2 3 4 5 6 7 8 9 好友 4 7 2 9 6 0 8 1 5 3 - 0 的好友是 4,4 的好友是 6,6 的好友是 8,8 的好友是 5,5 的好友是 0,所以 0、4、6、8、和 5 就形成了一個小群體。另外,1 的好友是 7 而且 7 的好友是 1,所以 1 和 7 形成另一個小群體,同理,3 和 9 是一個小群體,而 2 的好友是自己,因此他自己是一個小群體。
- 總而言之,在這個例子裡有 4 個小群體:{0,4,6,8,5}、{1,7}、{3,9}、{2}。
- 本題的問題是:輸入每個人的好友編號,計算出總共有幾個小群體。
- Q 同學想了想卻不知如何下手,和藹可親的 P 老師於是給了他以下的提示:如果你從任何一人 x 開始,追蹤他的好友,好友的好友,….,這樣一直下去,一定會形成一個圈回到 x,這就是一個小群體。
- 如果我們追蹤的過程中把追蹤過的加以標記,很容易知道哪些人已經追蹤過,因此,當一個小群體找到之後,我們再從任何一個還未追蹤過的開始繼續找下一個小群體,直到所有的人都追蹤完畢。
- Q 同學聽完之後很順利的完成了作業。
- 在本題中,你的任務與 Q 同學一樣:給定一群人的好友,請計算出小群體個數。
- Q 同學正在學習程式,P 老師出了以下的題目讓他練習。
輸入
- 第一行是一個正整數 N,說明團體中人數。
- 第二行依序是 0 的好友編號、1 的好友編號、……、N-1 的好友編號。共有 N 個數字,包含 0 到 N-1 的每個數字恰好出現一次,數字間會有一個空白隔開。
輸出
- 請輸出小群體的個數。不要有任何多餘的字或空白,並以換行字元結尾。
輸入範例一
10
4 7 2 9 6 0 8 1 5 3
輸出範例 1
4
輸入範例二
3
0 2 1
輸出範例二
2
14.10.6. Drunk cockroach [2D List]
說明
- 403 教室裡住著一隻蟑螂,某日,403 常駐工友將這隻蟑螂灌醉,然後隨意丟到地板讓它亂走
- 已知 403 教室的高架地板共有 m*n 塊,而且這隻大蟑螂每一步可以走一塊高架地板(感謝那些書包裡塞滿食物的學生,讓牠長這麼大)
- 無聊的工友一面喝著酒一面統計蟑螂踩過每塊地板的次數,直到每塊地板至少都被踩過一次後,工友就把蟑螂丟出窗外,結束快樂的一天
- 請列出在蟑螂非志願飛出窗外後,所有地板被踩次數的總和
輸入
- 第一行有 m,n 兩個數,代表 403 教室地板的組成
- 第二行有兩個數,表示蟑螂一開始被丟在第幾號地板(最左上角的地板編號為(0, 0) )
- 第三行有一大串的 1~4 的數字,這些數字分別代表蟑螂的行動軌跡,這串數字絕對足夠多到讓蟑螂走完每一塊地板
- 表示蟑螂接下來會往上走一格
- 表示蟑螂接下來會往右走一格
- 表示蟑螂接下來會往下走一格
- 表示蟑螂接下來會往左走一格
- 表示蟑螂接下來會往上走一格
- 如果蟑螂走到撞牆,就會回到前一格,次數仍然+1
- 蟑螂一開始被丟下去的那塊地板,也算被踩過一次
輸入範例
- 3 3
- 1 2
- 3 2 3 1 1 1 4 4 3 3 2 1 2 3 3 4 1 2 2
最後地板統計會變成如下統計表(含起始那塊)
1 1 2 1 1 2 1 1 3 - 蟑螂走到第 12 步時,所有地板都至少被踩過一次,之後的數字就不用再看了
輸出範例
- 13
15. 資料型別-字典 dict
前面介紹的 List 是用 index(數字編號)來存取資料,但有時候我們希望用一個「名字」來查資料,就像查字典一樣——你知道一個字(key),就可以查到它的解釋(value)。Python 的字典(dict)就是這種「key 對應 value」的資料結構。
例如,想要儲存每個學生的成績,用 List 的話你只能記住「第 0 個是 95 分、第 1 個是 100 分」,但用字典就可以直接寫「John 是 95 分、May 是 100 分」,這樣查起來直覺多了。
15.1. 資料格式
- 以{ }將各組鍵:值(key:value)對應資料含括起來,以 , 分隔
- 字典中資料的順序: 自 Python 3.7 起,字典會保留資料的插入順序 (你先放進去的資料就排在前面)。在更早的版本(3.6 以前)字典是無序的,所以網路上的舊教學常說「字典無序」,用現在的 Python 實測會發現順序其實是固定的
- 注意:雖然字典會保留插入順序,但它是用 key 來查資料,不能像 List 一樣用 index(數字編號)存取
- 格式:字典名稱 = {k1:v1, k2:v2, … }
- 註:若字典中有相同的 key,則會取出最後的 value
15.2. 範例
1: data = { 'John': 95, 'May': 100 } 2: print(data['May'])
100
15.3. dic 操作
- 新增、修改、刪除
1: data = { 'John': 95, 'May': 100 } 2: # 新增 3: data['Harrison'] = 88 4: # 修改 5: data['John'] = 99 6: # 刪除鍵值對 7: del data['John'] 8: print(data) 9: # 刪除dic 10: del data 11: # print(data) --> NameError: name 'data' is not defined
{'May': 100, 'Harrison': 88}
15.4. dic method
15.4.1. 建立一個空字典
1: data = {}
15.4.2. 加新值到字典中
1: data = {} 2: data['Vanessa'] = 95 3: print(data)
15.4.3. 取出字典中的資料
- <dict>.items()
- <dict>.keys()
<dict>.values()
1: data = { 'Vanessa': 95, 'May': 100, 'John': 105 } 2: print(data.values()) #傳回 dict_values 檢視物件(不是 List,不能用 index 存取;需要時可用 list() 轉成 List) 3: print(data.keys()) #傳回 dict_keys 檢視物件 4: print(data.items()) #傳回 dict_items 檢視物件(裡面的元素為 (key, value) 的 tuple)
dict_values([95, 100, 105]) dict_keys(['Vanessa', 'May', 'John']) dict_items([('Vanessa', 95), ('May', 100), ('John', 105)])<dict>.get(key, default=None)
1: data = { 'Vanessa': 95, 'May': 100, 'John': 105 } 2: print(data.get('Vanessa'))
15.4.4. 為什麼要用get()?
get()可以依照key取value,但是如果只是為了這個目的,直接用data[key]也可以,像這樣:
1: data = { 'Vanessa': 95, 'May': 100, 'John': 105 } 2: print(data['Vanessa']) 3: print(data.get('Vanessa'))
95 95
看起來二者並沒有什麼差別,那為什麼還要用get()呢?
原因是:當key不存在時,data[key]會產生KeyError錯誤,而get()則會回傳None或是指定的default值。例如:
1: data = { 'Vanessa': 95, 'May': 100, 'John': 105 } 2: #print(data['Ruby']) #會產生KeyError錯誤 3: print(data.get('Ruby')) #回傳None 4:
None
上面的第二行會出現以下錯誤:
1: File "<stdin>", line 2, in <module> 2: KeyError: 'Ruby'
這就是data[key]和get()的差別所在。
get() 還有一個實用技巧:你可以指定 default 值,這在計數的時候特別好用:
1: data = {} 2: for fruit in ['apple', 'banana', 'apple', 'apple', 'banana']: 3: data[fruit] = data.get(fruit, 0) + 1 # key 不存在時回傳 0,而非 None 4: print(data)
{'apple': 3, 'banana': 2}
其實,如果善用in這個運算子,也可以避免KeyError錯誤,例如:
1: data = { 'Vanessa': 95, 'May': 100, 'John': 105 } 2: key = 'Ruby' 3: if key in data: 4: print(data[key]) 5: else: 6: print("Key not found")
Key not found
15.4.5. 刪除字典裡的元素
- <dict>.clear(): 清除所有元素
- <dict>.popitem(): 移除並回傳最後加入的 key-value(以 Tuple 回傳)
- <dict>.pop(key[, default]): 移除指定 key 並回傳其 value。若 key 不存在且有給 default 則回傳 default,否則產生 KeyError
- <dict>.copy(): 淺拷貝整個字典
1: data = { 'Vanessa': 95, 'May': 100, 'John': 105, 'Ruby': 89 } 2: print("data:",data) 3: 4: pop1 = data.popitem() 5: print(pop1) # 以Tuple型式傳回 6: print(data) 7: print("data.clear():",data.clear()) 8: print(data)
data: {'Vanessa': 95, 'May': 100, 'John': 105, 'Ruby': 89}
('Ruby', 89)
{'Vanessa': 95, 'May': 100, 'John': 105}
data.clear(): None
{}
dict.pop() 範例
1: data = { 'Vanessa': 95, 'May': 100, 'John': 105 } 2: val = data.pop('May') # 移除 'May',回傳 100 3: print(val, data) 4: val2 = data.pop('Ruby', -1) # 'Ruby' 不存在,回傳 default 值 -1 5: print(val2, data)
100 {'Vanessa': 95, 'John': 105}
-1 {'Vanessa': 95, 'John': 105}
15.4.6. 更新字典: dict.update()
dict.update(other) 可以用另一個字典(或 key-value 的序列)來批量更新字典。如果 key 已存在就覆蓋,不存在就新增。
1: data = { 'Vanessa': 95, 'May': 100 } 2: data.update({'May': 88, 'Ruby': 77}) # May 被覆蓋,Ruby 是新增 3: print(data)
{'Vanessa': 95, 'May': 88, 'Ruby': 77}
15.4.7. 找出字典中某個 value 的 key: index
Solution #1: 用 for 迴圈一個一個找
1: data = { 'Vanessa': 95, 'May': 100, 'John': 98 , 'Ruby': 88, 'Harrison': 100} 2: #找出98分的人 3: for k, v in data.items(): 4: if v == 98: 5: print(k)
John
Solution #2: 把 key,values 轉成 list 後再用 index 來找
- 把 dic.keys()轉成 list
- 把 dic.values()轉成 list
- 利用 list 的 index
1: data = { 'Vanessa': 95, 'May': 100, 'John': 98 , 'Ruby': 88, 'Harrison': 100} 2: kl = list(data.keys()) 3: vl = list(data.values()) 4: #找出98分的人 5: print(kl) 6: print(vl) 7: print(kl[vl.index(98)])
['Vanessa', 'May', 'John', 'Ruby', 'Harrison'] [95, 100, 98, 88, 100] John
簡化版
1: # 學生成績字典 2: data = {'Vanessa': 95, 'May': 100, 'John': 98, 'Ruby': 89, 'Me': 98} 3: 4: # 使用字典遍歷找到對應的 key 5: matching_keys = [key for key, value in data.items() if value == 98] 6: print(matching_keys)
['John', 'Me']
15.4.8. 遍歷 Dict
1: data = { 'John': 95, 'May': 100, 'Vanessa': 105, 'James': 999 } 2: for k, v in data.items(): 3: print(k, ": ", v)
John : 95 May : 100 Vanessa : 105 James : 999
15.4.9. fromkeys
- <dict>.fromkeys(<seq>[, val]): Python 字典 fromkeys() 函數用於創建一個新字典,以序列 seq 中元素做字典的鍵,value 為字典所有鍵對應的初始值。
1: name = ('Vanessa', 'May', 'John') 2: data = dict.fromkeys(name) 3: print(data) 4: data = dict.fromkeys(name, 100) 5: print(data)
{'Vanessa': None, 'May': None, 'John': None}
{'Vanessa': 100, 'May': 100, 'John': 100}
15.5. 練習
從以下字典中找出最小 value 對應的 key
sampleDict = {
'Physics': 82,
'Math': 65,
'history': 75
}
Expected output:
Math
15.6. 進階閱讀
- python dict 的運作原理(Hash table): https://www.youtube.com/watch?v=ea8BRGxGmlA
15.7. 不同型別的互換
Python 提供了 list()~、~tuple()~、~set() 等函式,可以在不同的資料型別之間互相轉換。轉換時要注意:轉成 set 會自動去除重複元素,而且順序不保證。
15.7.1. 字串 -> list, tuple, set
1: sh = 'TNSSH' 2: print(list(sh)) 3: print(tuple(sh)) 4: print(set(sh)) #注意集合的內容及順序
['T', 'N', 'S', 'S', 'H']
('T', 'N', 'S', 'S', 'H')
{'H', 'S', 'N', 'T'}
15.7.2. list -> tuple, set
1: ls = 'to die or not to die that is a question' 2: l = ls.split() 3: print(l) 4: print(tuple(l)) 5: print(set(l))#留意集合的內容及順序
['to', 'die', 'or', 'not', 'to', 'die', 'that', 'is', 'a', 'question']
('to', 'die', 'or', 'not', 'to', 'die', 'that', 'is', 'a', 'question')
{'a', 'is', 'to', 'not', 'die', 'question', 'or', 'that'}
15.7.3. dict -> list, tuple, set
1: dic = {'A':89, 'B':100, 'C': 78, 'D': 100} 2: print(list(dic.keys())) 3: print(list(dic.values())) 4: print(tuple(dic.keys())) 5: print(tuple(dic.values())) 6: print(set(dic.keys())) 7: print(set(dic.values())) 8:
['A', 'B', 'C', 'D']
[89, 100, 78, 100]
('A', 'B', 'C', 'D')
(89, 100, 78, 100)
{'A', 'C', 'D', 'B'}
{89, 100, 78}
15.7.4. 類推
其他的型別互換,如 tuple->list, tuple->set 請自行類推…..
15.8. 資料型別整理
| 資料型別 | 符號 | 資料可改? | 資料有序? | 資料類型 |
|---|---|---|---|---|
| 字串 string | ' ' 或 " " | ✖️ | ✔️ | 相同(字元) |
| 表列 List | [ ] | ✔️ | ✔️ | 可不同 |
| 元組 tuple | ( ) | ✖️ | ✔️ | 可不同 |
| 字典 dict | { } | ✔️ | ✔️(3.7起) | 相同(鍵:值) |
| 集合 set | { } | ✔️ | ✖️ | 可不同 |
- 註:字典自 Python 3.7 起保證維持插入順序(3.6 以前為無序),但仍是以 key 存取,不能用 index。
15.8.1. Complete String
說明
- 如果有兩個字串(字串由小寫英文字母組成),其相加結果可以涵蓋所有的英文字母(a~z),那我們就說這兩個字串為 complete
- 例如,字串 A 為 abcdefghijklmn ,字串 B 為 lmnopqrstuvwxyz,那就符合上述狀況
- 給你兩堆字串,請問,從這兩堆字串中各任選一字串出來做相加,其相加結果有幾種可能可以成為 complete
輸入範例
- 第一列有很多字串(字串由小寫英文字母組成)
- 第二列也有很多字串(字串由小寫英文字母組成)
輸出範例
- 第?組: 字串相加結果
輸入
abcde wxyz
defghijklmnopqrstuvwxyz abcdefghijklmnopqrstuvwx vvvopqrstabcdefghijklmuvwxyzmmmnnnn
輸出
1: abcdedefghijklmnopqrstuvwxyz
2: abcdevvvopqrstabcdefghijklmuvwxyzmmmnnnn
3: wxyzabcdefghijklmnopqrstuvwx
4: wxyzvvvopqrstabcdefghijklmuvwxyzmmmnnnn
提示
你可以從這段程式碼開始做起
1: ListA = 'abcde wxyz'.split() 2: ListB = 'defghijklmnopqrstuvwxyz abcdefghijklmnopqrstuvwx vvvopqrstabcdefghijklmuvwxyzmmmnnnn'.split() 3: